Intelligence Artificielle

Checklist d’audit — Git Worktrees multi-instance

Objectif : auditer le setup actuel et vérifier qu’un nombre arbitraire de worktrees peut tourner simultanément sans collision, contamination croisée ou effet de bord.

Pour chaque point :

  • Vérifier l’implémentation réelle dans le projet
  • Indiquer OK, RISQUE, MANQUANT ou NON APPLICABLE
  • Citer les fichiers/configurations concernés
  • Ne modifier aucun fichier pendant l’audit
  • À la fin, produire une liste priorisée des problèmes trouvés

1. Git / Worktrees

  • Chaque worktree utilise une branche Git distincte
  • Le script empêche de réutiliser accidentellement une branche déjà montée dans un autre worktree
  • Le worktree principal est correctement distingué des worktrees secondaires
  • La suppression d’un worktree ne supprime pas une branche ou des données non fusionnées sans avertissement
  • git worktree prune est géré ou documenté
  • Les worktrees supprimés ne laissent pas d’entrées Git orphelines
  • Les fichiers non trackés importants ne sont pas supposés être partagés entre worktrees
  • Aucun script ne suppose implicitement que le dépôt courant est le worktree principal
  • Les chemins reposent sur la racine réelle du worktree et non sur un chemin absolu codé en dur
  • Les hooks Git éventuellement utilisés fonctionnent depuis tous les worktrees
  • Les scripts savent correctement retrouver le common Git dir et le worktree courant

2. Identité unique du worktree

  • Chaque worktree possède un identifiant unique et stable
  • Cet identifiant est dérivé de manière déterministe ou enregistré explicitement
  • Les noms contenant /, _, espaces ou caractères spéciaux sont normalisés
  • Deux branches dont les noms se ressemblent ne peuvent pas générer le même identifiant
  • Il existe une stratégie pour éviter les collisions après troncature des noms
  • L’identifiant est utilisé partout où une ressource doit être isolée

3. Variables d’environnement

  • Chaque worktree possède son propre .env
  • Le .env n’est jamais partagé par symlink sauf intention explicite
  • Le script initialise correctement un nouveau .env
  • Les secrets communs éventuels sont séparés des valeurs propres au worktree
  • APP_ENV est cohérent
  • APP_URL est propre au worktree
  • Les variables générées automatiquement sont idempotentes
  • Une relance du script ne détruit pas des modifications manuelles du .env
  • Les variables obligatoires manquantes sont détectées avant le démarrage

4. Hostnames / URLs

  • Chaque worktree possède un hostname distinct
  • Aucun hostname ne peut entrer en collision
  • La génération du hostname supporte correctement les noms de branches complexes
  • /etc/hosts, DNS local ou wildcard DNS est correctement géré
  • Les entrées obsolètes peuvent être nettoyées
  • Le reverse proxy route vers le bon worktree
  • HTTP et HTTPS sont gérés de manière cohérente
  • Les certificats locaux éventuels supportent les hostnames générés
  • Les redirects Laravel ne renvoient pas vers le hostname d’un autre worktree
  • Les URLs générées par les jobs/CLI utilisent le bon APP_URL

5. Ports

  • Tous les services nécessitant un port peuvent fonctionner simultanément
  • Le port HTTP est unique
  • Le port Vite est unique
  • Le port WebSocket/Reverb est unique
  • Les ports de debug éventuels sont uniques
  • Les ports des outils annexes sont uniques
  • L’allocation des ports résiste au lancement concurrent de deux créations de worktree
  • Un port déjà occupé est détecté avant démarrage
  • Les ports libérés peuvent être réutilisés sans collision
  • Aucun port fixe caché n’est présent dans les scripts/configurations

6. Base de données

  • Chaque worktree utilise une base isolée
  • Le nom de base est unique
  • Les migrations d’un worktree ne peuvent pas modifier la DB d’un autre
  • migrate:fresh, db:wipe ou équivalent ne peut pas toucher une autre instance
  • Les seeds sont exécutés sur la bonne DB
  • Les tests utilisent une DB propre au worktree
  • Les connexions secondaires éventuelles sont également isolées
  • Les DB de tests sont distinctes des DB de développement
  • La suppression du worktree gère explicitement le devenir de sa DB
  • Une protection existe contre la suppression accidentelle de la DB principale

7. Redis

  • Cache Redis isolé par worktree
  • Sessions Redis isolées
  • Queues Redis isolées
  • Locks Redis isolés
  • Rate limiting isolé si nécessaire
  • Broadcast/pub-sub isolé
  • Horizon utilise le bon namespace
  • Aucun flushdb ou flushall utilisé par un worktree ne peut casser les autres
  • Les clés applicatives possèdent un préfixe unique

8. Cache Laravel

  • CACHE_PREFIX est unique
  • php artisan cache:clear ne vide pas les données des autres worktrees
  • Le config cache est local au worktree
  • Le route cache est local au worktree
  • Le view cache est local au worktree
  • bootstrap/cache n’est pas partagé
  • storage/framework/cache n’est pas partagé

9. Sessions / Cookies

  • Nom du cookie de session unique
  • Domaine du cookie cohérent avec le hostname
  • Les sessions d’un worktree ne sont pas réutilisées dans un autre
  • Les cookies CSRF/XSRF ne provoquent pas de collisions
  • Les cookies d’authentification persistante sont isolés
  • Sanctum fonctionne correctement avec les domaines générés
  • Les domaines stateful Sanctum sont correctement définis

10. Queues

  • Chaque worktree possède sa queue ou son namespace
  • Un worker d’un worktree ne peut pas consommer les jobs d’un autre
  • Les failed jobs restent identifiables par worktree
  • Horizon sépare correctement les environnements
  • Les workers sont arrêtés lors de la suppression/arrêt d’un worktree
  • queue:restart d’un worktree ne perturbe pas les autres
  • Les jobs sérialisés ne dépendent pas d’un chemin absolu d’un autre worktree

11. Scheduler / Cron

  • Le scheduler ne s’exécute pas involontairement dans tous les worktrees
  • Une stratégie explicite détermine quels worktrees peuvent lancer le scheduler
  • withoutOverlapping() ne partage pas accidentellement ses locks entre instances
  • onOneServer() a le comportement attendu
  • Les tâches ayant des effets externes ne sont pas dupliquées
  • Les cron système éventuels ne pointent pas vers un ancien worktree

12. Storage / fichiers locaux

  • Chaque worktree possède son propre storage/
  • storage/app n’est pas partagé involontairement
  • storage/logs est distinct
  • storage/framework est distinct
  • Les uploads locaux ne contaminent pas les autres worktrees
  • Les fichiers temporaires sont isolés
  • Les exports/imports sont isolés
  • Les storage:link pointent vers le bon worktree
  • Les symlinks sont vérifiés après création
  • Aucun chemin absolu vers un ancien worktree n’est stocké

13. Logs

  • Les logs permettent d’identifier le worktree d’origine
  • Deux worktrees n’écrivent pas dans le même fichier de log sauf intention explicite
  • Les logs des workers sont distinguables
  • Les logs du scheduler sont distinguables
  • Les logs du reverse proxy permettent d’identifier l’instance
  • Le nom du worktree est injecté dans le contexte de logging si utile

14. Composer / PHP

  • Chaque worktree possède son propre vendor/
  • composer.lock correspond bien à chaque branche
  • Aucun vendor partagé ne peut être écrasé par un autre worktree
  • La version PHP utilisée est cohérente
  • Les extensions PHP requises sont disponibles
  • Les scripts Composer post-install ne touchent pas des ressources globales dangereuses
  • Les caches Composer éventuellement partagés sont uniquement des caches de téléchargement

15. Node / npm / Vite

  • Chaque worktree possède son propre node_modules
  • Le lockfile propre à la branche est respecté
  • Le serveur Vite possède un port unique
  • HMR fonctionne avec le hostname du worktree
  • Les URLs HMR/WebSocket sont correctes
  • Les fichiers générés dans public/build sont locaux au worktree
  • Un npm install dans un worktree ne modifie pas les dépendances d’un autre
  • Les caches npm/pnpm/yarn partagés ne contiennent que des artefacts sûrs à partager

16. Docker si utilisé

  • COMPOSE_PROJECT_NAME est unique par worktree
  • Aucun container_name fixe ne crée de collision
  • Les networks sont correctement namespacés
  • Les volumes sont correctement namespacés
  • Les bind mounts pointent vers le worktree courant
  • Les ports exposés sont uniques
  • docker compose down d’un worktree ne détruit pas les containers d’un autre
  • docker compose down -v ne supprime pas des volumes partagés importants
  • Les services volontairement partagés sont clairement identifiés
  • La destruction d’un worktree ne détruit jamais l’infrastructure commune

17. Services externes

Vérifier particulièrement :

  • Email
  • SMS
  • Stripe/paiements
  • Webhooks
  • OpenAI / LLM
  • Telegram
  • Slack
  • APIs métier
  • S3 / object storage
  • Search engines
  • OAuth providers

Pour chacun :

  • L’environnement de développement utilise sandbox/test quand disponible
  • Un worktree secondaire ne peut pas déclencher involontairement une action production
  • Les callbacks utilisent le hostname du bon worktree
  • Les webhook URLs peuvent distinguer les worktrees
  • Les idempotency keys ne créent pas de collisions
  • Les emails/SMS de test sont interceptés si nécessaire

18. OAuth / authentification externe

  • Les redirect URIs supportent les différents hostnames
  • Google/GitHub/etc. acceptent les URLs générées
  • Les secrets ne sont pas recopiés inutilement
  • L’état OAuth/state/PKCE reste associé au bon worktree
  • Un login initié sur WT-A ne termine pas sur WT-B

19. Services partagés

Pour chaque service partagé, documenter explicitement :

  • MySQL
  • Redis
  • Mailpit/Mailhog
  • Elasticsearch/Meilisearch
  • MinIO
  • RabbitMQ
  • reverse proxy
  • autres

Puis vérifier :

  • Ce qui est partagé
  • Ce qui est namespacé
  • Ce qui est totalement isolé
  • Ce qui se passe lors d’un reset
  • Ce qui se passe lors de la suppression d’un worktree

20. Tests automatisés

  • Deux suites de tests peuvent tourner simultanément
  • Elles n’utilisent pas la même DB
  • Elles ne partagent pas les mêmes fichiers temporaires
  • Elles ne partagent pas les mêmes ports
  • Elles ne détruisent pas les données de l’autre
  • Les tests browser/E2E ciblent le bon hostname
  • Dusk/Playwright/Cypress peuvent tourner en parallèle
  • Les screenshots et artefacts de tests sont séparés
  • Les mails/jobs/fakes sont correctement isolés

21. Commandes destructives

Chercher toutes les commandes du type :

  • rm -rf
  • DROP DATABASE
  • db:wipe
  • migrate:fresh
  • cache:clear
  • redis flush*
  • docker compose down -v
  • suppression de volumes
  • suppression de répertoires
  • suppression de hosts/vhosts

Pour chacune :

  • La cible est explicitement limitée au worktree courant
  • Le script refuse les valeurs vides
  • Le script refuse /
  • Le script refuse le repository principal si ce n’est pas explicitement demandé
  • Une variable vide ne peut jamais élargir une commande destructive
  • Une protection existe contre les erreurs de quoting shell

22. Concurrence du script de création

Simuler deux commandes lancées exactement en même temps.

Vérifier :

  • Allocation atomique des ports
  • Allocation atomique des DB
  • Allocation atomique des hostnames
  • Écriture concurrente dans /etc/hosts
  • Écriture concurrente dans nginx
  • Création concurrente de fichiers registry
  • Absence de race condition
  • Utilisation de lock/flock si nécessaire

23. Idempotence

Pour toutes les commandes principales :

  • create
  • setup
  • start
  • stop
  • restart
  • remove
  • cleanup

Vérifier :

  • Une deuxième exécution ne casse rien
  • Une exécution interrompue peut être reprise
  • Un état partiellement créé est détecté
  • L’outil sait distinguer déjà fait de erreur
  • Un rollback ou cleanup est possible après erreur

24. Processus orphelins

Après arrêt/suppression d’un worktree :

  • Aucun serveur PHP orphelin
  • Aucun php artisan serve
  • Aucun worker queue
  • Aucun Horizon
  • Aucun scheduler
  • Aucun Vite
  • Aucun WebSocket server
  • Aucun processus Node
  • Aucun container Docker
  • Aucun tmux/screen/process manager associé inutilement

25. Process management

  • Le PID de chaque service est traçable
  • Un stop ne tue pas un processus appartenant à un autre worktree
  • Aucun pkill php / killall node générique dangereux
  • Les processus sont identifiés par PID, working directory ou identifiant spécifique
  • Le redémarrage cible uniquement le worktree courant

26. Nginx / reverse proxy

  • Un fichier vhost distinct existe par worktree
  • Les noms de fichiers sont uniques
  • La configuration est validée avant reload (nginx -t)
  • Une erreur dans un worktree ne casse pas les autres vhosts
  • Le nettoyage retire uniquement le vhost concerné
  • root pointe vers le bon /public
  • PHP-FPM reçoit le bon SCRIPT_FILENAME
  • Les hostnames wildcard et regex ne routent pas vers la mauvaise instance

27. WSL

  • Les chemins Windows/WSL ne sont pas mélangés de façon fragile
  • Aucun chemin /mnt/c/... codé en dur si non nécessaire
  • Les permissions Linux sont conservées
  • Les symlinks fonctionnent correctement
  • Les scripts fonctionnent après redémarrage WSL
  • Les IP dynamiques WSL ne sont pas supposées fixes
  • Les processus lancés sont bien visibles/arrêtables depuis WSL
  • Le navigateur Windows peut résoudre les hostnames utilisés

28. Multitenancy Laravel

Puisque l’application est multi-tenant :

  • L’identification du tenant ne dépend pas accidentellement du hostname de worktree
  • Le hostname de développement et le hostname métier du tenant sont correctement distingués
  • Les domaines tenant sont isolés entre worktrees
  • Les tenants créés dans WT-A ne sont pas visibles dans WT-B sauf intention explicite
  • Les DB tenant sont correctement isolées
  • Les queues tenant-aware ne traversent pas les worktrees
  • Les caches tenant-aware incluent aussi l’identité du worktree si nécessaire
  • Les cookies multi-tenant ne fuient pas entre instances
  • Les URLs générées pour les tenants utilisent le domaine attendu
  • Les commandes artisan tenant-aware utilisent la DB du worktree courant

29. Agents IA travaillant simultanément

Si plusieurs Claude Code / Codex / agents travaillent en parallèle :

  • Un agent = un worktree
  • Un agent = une branche
  • Les responsabilités sont suffisamment séparées
  • Deux agents ne modifient pas volontairement le même fichier sauf nécessité
  • Les agents n’exécutent pas de commandes Git sur le mauvais worktree
  • Les agents vérifient pwd, branche et git status avant opérations importantes
  • Aucun agent ne fait git reset --hard sans contrôle
  • Aucun agent ne fait git clean -fd sans contrôle
  • Aucun agent ne force-push une branche partagée
  • Les commits sont fréquents et atomiques
  • Chaque agent laisse le worktree dans un état récupérable
  • Les conflits sont résolus lors de l’intégration, pas masqués

30. Intégration entre branches

  • Une stratégie d’intégration est définie : merge, rebase ou cherry-pick
  • Les branches sont régulièrement resynchronisées avec la branche de référence si nécessaire
  • Les modifications de migrations concurrentes sont détectées
  • Les modifications concurrentes de composer.json sont détectées
  • Les modifications concurrentes de package.json sont détectées
  • Les modifications concurrentes de .env.example sont détectées
  • Les modifications concurrentes des configs centrales sont détectées
  • Une suite de tests complète est lancée après intégration

31. Observabilité

Idéalement, pouvoir exécuter une commande donnant :

Worktree      Branch          Host                       DB              HTTP  Vite  Status
main          main            huynh-yvon.team-of.test    app_main        80    5173  UP
auth          feat/auth       auth.team-of.test          app_auth        ...   ...   UP
billing       feat/billing    billing.team-of.test       app_billing     ...   ...   DOWN

Vérifier :

  • Branche
  • chemin
  • hostname
  • DB
  • ports
  • PID/processus
  • containers
  • état nginx
  • état queue
  • état Vite

32. Nettoyage complet

Lors de la suppression d’un worktree, vérifier explicitement le traitement de :

  • worktree Git
  • branche Git
  • DB
  • DB de tests
  • .env
  • hostname
  • /etc/hosts
  • vhost nginx
  • certificat local
  • Redis keys
  • queues
  • workers
  • scheduler
  • Docker containers
  • Docker networks
  • Docker volumes
  • logs
  • fichiers temporaires
  • PID files
  • storage
  • node_modules
  • vendor

Pour chaque ressource, préciser si elle est :

  • supprimée automatiquement ;
  • conservée volontairement ;
  • supprimée uniquement avec --purge.

33. Protection du worktree principal

  • Le worktree principal est explicitement identifiable
  • Les commandes destructives ont des protections supplémentaires sur celui-ci
  • Impossible de supprimer le worktree principal par erreur
  • Impossible de supprimer sa DB par erreur
  • Impossible de supprimer son vhost par erreur
  • Impossible de le traiter comme une instance temporaire sans confirmation explicite

34. Scénarios à réellement tester

Ne pas se limiter à lire le code. Si possible, tester :

  • Créer WT-A
  • Créer WT-B
  • Créer WT-C
  • Démarrer les trois simultanément
  • Ouvrir les trois applications simultanément
  • Authentification différente dans chaque instance
  • Écrire des données différentes dans chaque DB
  • Lancer des migrations différentes
  • Lancer des queues simultanément
  • Lancer Vite simultanément
  • Exécuter les tests simultanément
  • Redémarrer WT-B sans toucher A/C
  • Supprimer WT-B sans toucher A/C
  • Recréer WT-B
  • Lancer simultanément deux créations de worktree
  • Tuer brutalement un setup en cours puis le relancer
  • Redémarrer WSL puis relancer les worktrees
  • Vérifier qu’aucun processus/port/configuration fantôme ne subsiste

35. Recherche de dépendances cachées

Effectuer une recherche globale dans le repository pour détecter :

  • localhost
  • 127.0.0.1
  • ports codés en dur
  • noms de DB codés en dur
  • noms Redis codés en dur
  • domaines codés en dur
  • chemins absolus
  • chemins vers /home/...
  • chemins vers /mnt/c/...
  • APP_URL
  • VITE_
  • REDIS_
  • DB_
  • QUEUE_
  • SESSION_
  • CACHE_
  • BROADCAST_
  • REVERB_
  • SANCTUM_
  • noms de containers
  • noms de volumes Docker

Identifier tout élément qui devrait dépendre de l’identité du worktree mais ne le fait pas.

Rapport final attendu

À la fin de l’audit, produire exactement ces sections :

1. Verdict global

Donner une note sur 10 pour la robustesse du système multi-worktree.

2. Problèmes critiques

Uniquement les problèmes susceptibles de :

  • corrompre des données ;
  • toucher un autre worktree ;
  • toucher la production ;
  • supprimer des ressources ;
  • provoquer des comportements non déterministes.

3. Risques moyens

Problèmes pouvant provoquer des collisions, bugs ou difficultés d’exploitation sans risque majeur de perte de données.

4. Améliorations mineures

Ergonomie, observabilité, nettoyage, simplification.

5. Éléments correctement implémentés

Lister ce qui a réellement été vérifié dans le code et qui est robuste.

6. Tests manquants

Lister les scénarios qui ne sont pas couverts actuellement.

7. Ressources non isolées

Créer un tableau :

RessourceIsoléePartagée volontairementRisque
DB
Redis
Cache
Sessions
Queues
Storage
Logs
HTTP
Vite
WebSockets
Scheduler
Services externes

8. Top 10 des actions recommandées

Classer par priorité réelle.

Règle importante pour cet audit

Ne suppose pas qu’un mécanisme fonctionne parce qu’un fichier ou une variable existe.

Trace réellement le flux :

création du worktree → génération config → démarrage → runtime → arrêt → suppression

et cherche particulièrement :

  • les ressources globales cachées ;
  • les variables partagées ;
  • les chemins absolus ;
  • les ports fixes ;
  • les commandes destructives ;
  • les race conditions ;
  • les processus orphelins ;
  • les effets de bord externes.

Le but n’est pas de confirmer que le système semble correct.

Le but est d’essayer activement de trouver une façon de le casser.
J’ai fait tourner un LLM 27B à 45 tokens/s sur une RTX 5060 Ti 16 Go

Prism LM ous offre un Qwen 27B 9x plus petit

Faire tourner un modèle de 27 milliards de paramètres en local avec seulement 16 Go de VRAM, ça paraît ambitieux.

C’est pourtant ce que j’ai réussi à faire avec Bonsai 2 27B de PrismML, une NVIDIA RTX 5060 Ti 16 Go, Windows et WSL2.

C’est intéressant pour un développeur car Qwen est considéré comme un remplaçant de Claude en open weight. Imaginez pouvoir coder avec un nombre de tokens infini !

Le résultat obtenu est plutôt impressionnant :

Prompt :     181.2 tokens/s
Génération : 45.4 tokens/s  << très bon en fait

Le modèle GGUF ne pèse qu’environ 7,2 Go, malgré ses quelque 26,9 milliards de paramètres.

Dans cet article, je ne vais pas détailler toutes les tentatives qui ont échoué. Je vais directement montrer la configuration qui a fonctionné.


La configuration utilisée

Ma machine :

  • Windows
  • WSL2
  • Ubuntu 26.04
  • NVIDIA RTX 5060 Ti
  • 16 Go de VRAM
  • 32 Go de RAM
  • CUDA Toolkit 13.4
  • Bonsai 2 27B PQ2_0

Premier test depuis WSL :

nvidia-smi

La RTX 5060 Ti est correctement reconnue avec environ 16 Go de VRAM.

Attention aux versions CUDA

Chez moi, nvidia-smi indique :

CUDA Version: 13.1

alors que :

nvcc --version

renvoie :

Cuda compilation tools, release 13.4, V13.4.92

Ce n’est pas contradictoire.

nvidia-smi donne une information liée au support CUDA du driver NVIDIA alors que nvcc indique la version du CUDA Toolkit réellement installé.


Installer CUDA sous WSL2

J’ai d’abord essayé d’installer l’ensemble du toolkit CUDA.

Mais sur Ubuntu 26.04, cela entraînait des dépendances supplémentaires, notamment autour des outils graphiques NVIDIA et de Nsight.

Pour compiler et exécuter Bonsai, je n’avais pas besoin de tout cela.

L’installation minimale qui a fonctionné :

sudo apt install -y cuda-compiler-13-4 cuda-libraries-dev-13-4

J’ai ensuite ajouté CUDA à mon environnement :

echo 'export PATH=/usr/local/cuda-13.4/bin:$PATH' >> ~/.bashrc
echo 'export LD_LIBRARY_PATH=/usr/local/cuda-13.4/lib64:$LD_LIBRARY_PATH' >> ~/.bashrc
source ~/.bashrc

Puis :

nvcc --version

À ce stade, CUDA était opérationnel.


Installer Bonsai 2 27B

Point important : je n’ai finalement pas installé llama.cpp séparément.

Le projet Bonsai fournit les scripts et binaires dont il a besoin.

J’ai simplement cloné le dépôt :

cd ~
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo

Puis lancé :

./setup.sh

Après téléchargement et préparation de l’environnement :

Setup complete!
BONSAI_FAMILY=bonsai2
BONSAI_MODEL=27B

Le dépôt contenait notamment son propre :

bin/cuda/llama-cli

C’est donc cette version qui est utilisée pour Bonsai.


Un modèle 27B dans seulement 7,2 Go

Le modèle installé est :

Ternary-Bonsai-2-27B-PQ2_0.gguf

Il se trouve dans :

~/Bonsai-demo/models/bonsai2-gguf/27B/

Le serveur rapporte environ :

26 895 998 464 paramètres
7 195 047 936 octets
PQ2_0
2.13 bpw

Donc environ 26,9 milliards de paramètres dans un fichier de seulement 7,2 Go.

C’est précisément ce qui rend ce type de modèle intéressant pour les GPU disposant de 16 Go de VRAM.


Lancer Bonsai 2

Le lancement est très simple :

cd ~/Bonsai-demo
./scripts/run_llama.sh

Le script sélectionne automatiquement le modèle et le backend CUDA.

Une fois chargé, on peut directement discuter avec le modèle depuis le terminal.


45 tokens/s sur une RTX 5060 Ti

C’était évidemment le test que j’attendais le plus.

Sur ma RTX 5060 Ti 16 Go :

Prompt: 181.2 t/s
Generation: 45.4 t/s

Il faut distinguer les deux valeurs.

181 tokens/s correspondent essentiellement au traitement du prompt initial.

45 tokens/s correspondent à la génération des nouveaux tokens.

Pour l’utilisation quotidienne, c’est surtout le deuxième chiffre qui compte.

Et à environ 45 tokens par seconde, l’utilisation interactive est très confortable.


Pourquoi Bonsai affiche-t-il son raisonnement ?

Au premier test, j’ai également vu apparaître quelque chose d’assez inhabituel :

[Start thinking]

We need to respond to user...

Puis le modèle analyse la demande avant de produire sa réponse.

Ce n’est pas un bug.

Bonsai 2 fonctionne avec un mécanisme de raisonnement et le script fourni conserve ce comportement.

Dans une interface utilisateur, on pourrait évidemment choisir de masquer cette partie pour ne présenter que la réponse finale.


Transformer Bonsai en serveur API local

Faire discuter le modèle dans un terminal est intéressant.

Mais mon véritable objectif est de pouvoir l’utiliser depuis d’autres applications et notamment depuis des agents de développement.

Bonsai fournit justement llama-server.

Le lancement standard est :

./scripts/start_llama_server.sh

Chez moi, le port 8080 était déjà utilisé par Stremio.

Pas de problème : le script permet de changer le port.

J’utilise donc :

PORT=8081 ./scripts/start_llama_server.sh

On peut vérifier immédiatement l’API :

curl http://localhost:8081/v1/models

Le serveur répond correctement et expose le modèle Bonsai.

J’ai également testé directement l’endpoint :

/v1/responses

avec une requête simple : HTTP 200.


Peut-on utiliser Bonsai avec Codex CLI ?

C’était mon test suivant.

J’utilise régulièrement Codex CLI et l’idée était séduisante :

Codex CLI
    ↓
Bonsai 2 27B
    ↓
RTX 5060 Ti

Autrement dit : remplacer le modèle distant par mon modèle local.

J’ai configuré Codex pour utiliser :

http://localhost:8081/v1

Codex reconnaît effectivement Bonsai.

L’écran indique bien :

model:
/home/yvonh/Bonsai-demo/models/bonsai2-gguf/27B/Ternary-Bonsai-2-27B-PQ2_0.gguf

Mais au premier prompt :

We're currently experiencing high demand,
which may cause temporary errors.

Étrange pour un modèle qui tourne… sur ma propre machine.


Le message « high demand » était trompeur

En regardant directement les logs de llama-server, j’ai découvert la véritable erreur :

unsupported Responses tool type 'namespace' skipped

ainsi que :

unsupported Responses tool type 'web_search' skipped

Et surtout :

Jinja Exception:
System message must be at the beginning.

Le serveur finissait donc par retourner une erreur HTTP 500.

Codex transformait simplement cette erreur en message générique :

We're currently experiencing high demand

Le problème n’était donc absolument pas une saturation de Bonsai.


Pourquoi Codex et Bonsai ne fonctionnent pas encore ensemble ?

Une requête simple sur /v1/responses fonctionne.

Mais Codex n’envoie pas une requête simple.

Un agent de développement manipule des outils, des commandes, des fichiers et différents types de messages.

Dans mon cas, Codex envoyait notamment des tools que le serveur Bonsai ne reconnaissait pas :

namespace
web_search

Le template utilisé par le modèle imposait également une contrainte sur la position du message system.

On se retrouve donc avec :

Codex CLI
     ↓
Responses API
     ↓
tools + instructions
     ↓
incompatibilité de format
     ↓
llama-server
     ↓
HTTP 500

Le problème est donc une incompatibilité entre les protocoles/templates, pas un manque de puissance du modèle.


Prochaine étape : utiliser Aider

Plutôt que de commencer immédiatement à écrire un proxy entre Codex et Bonsai, j’ai décidé de tester une solution plus simple : Aider.

Aider est également un agent de programmation utilisable directement depuis le terminal.

L’idée devient :

Aider
   ↓
API OpenAI-compatible
   ↓
llama-server
   ↓
Bonsai 2 27B
   ↓
RTX 5060 Ti

Je garde volontairement mes différents composants séparés :

/home/yvonh/
├── Bonsai-demo/     # modèle + serveur
├── aider-env/       # Aider
└── team-of/         # projet de développement

L’installation d’Aider se fera dans son propre environnement Python.


Ce que je retiens de cette expérience

Le résultat le plus intéressant n’est finalement même pas la configuration de WSL ou CUDA.

C’est ce chiffre :

Bonsai 2 27B
≈ 26,9 milliards de paramètres
≈ 7,2 Go de GGUF
RTX 5060 Ti 16 Go
≈ 45 tokens/s

Il devient donc parfaitement réaliste de faire tourner un modèle de près de 27 milliards de paramètres sur une carte graphique grand public de 16 Go.

Et avec 45 tokens/s, on ne parle pas seulement d’une démonstration technique.

Le modèle est suffisamment rapide pour être réellement utilisé.


Conclusion

Mon environnement final ressemble aujourd’hui à ceci :

Windows
   │
   └── WSL2
        │
        └── Ubuntu 26.04
             │
             ├── CUDA 13.4
             │
             └── Bonsai-demo
                    │
                    └── Bonsai 2 27B PQ2_0
                           │
                           └── RTX 5060 Ti 16 Go
                                  │
                                  └── ~45 tokens/s

La partie LLM local fonctionne.

La partie serveur API fonctionne.

Le prochain objectif est maintenant plus ambitieux : voir si ce 27B peut réellement remplacer une partie des modèles cloud dans mon workflow de développement.

Et notamment répondre à une question beaucoup plus intéressante que « est-ce que le modèle démarre ? » :

un modèle 27B local à 45 tokens/s est-il suffisamment bon pour travailler comme véritable agent de développement sur une base de code réelle ?

C’est ce que je vais tester avec Aider.


Mots-clés : Bonsai 2 27B, PrismML, RTX 5060 Ti, LLM local, llama.cpp, llama-server, WSL2, CUDA, GGUF, Aider, Codex CLI, IA locale, modèle 27B, NVIDIA 16 Go.

Faire tourner Pi Coding Agent avec un LLM local Bonsai dans WSL

Faire tourner Pi Coding Agent avec un LLM local Bonsai dans WSL

Je voulais utiliser un LLM local pour coder dans WSL, avec un vrai agent capable de lire les fichiers, lancer des commandes et travailler directement sur un projet.

J’ai d’abord testé Aider, mais pour mon besoin, Pi Coding Agent s’est révélé plus adapté grâce à son approche orientée outils.

Voici la configuration qui a fonctionné.

1. Mon setup

J’utilise :

  • WSL
  • un modèle local Bonsai 27B au format GGUF
  • llama.cpp comme serveur local (attention c’est un fork adapté à Bonsai)
  • Pi Coding Agent comme agent de code

Mon modèle :

/home/yvonh/Bonsai-demo/models/bonsai2-gguf/27B/Ternary-Bonsai-2-27B-PQ2_0.gguf

Mon binaire llama.cpp :

/home/yvonh/Bonsai-demo/bin/cuda/llama-server

2. Lancer Bonsai avec llama.cpp

Attention c’est le llma.cpp propre à Bonsai, ce n’est pas le llam.cpp que vous voyez habituellement.

La commande fonctionnelle est :

/home/yvonh/Bonsai-demo/bin/cuda/llama-server -m /home/yvonh/Bonsai-demo/models/bonsai2-gguf/27B/Ternary-Bonsai-2-27B-PQ2_0.gguf --ctx-size 32768 --port 8081

Le serveur expose ensuite une API compatible OpenAI sur :

http://localhost:8081/v1

Pour vérifier que le modèle est bien exposé :

curl http://localhost:8081/v1/models

3. Attention à la fenêtre de contexte

Au départ, le serveur tournait avec une fenêtre de contexte de :

16384 tokens

Pi envoyait une requête d’environ 17 852 tokens, ce qui provoquait l’erreur :

400 request exceeds the available context size

La solution a été d’augmenter le contexte de llama.cpp :

--ctx-size 32768

Il faut aussi déclarer la même taille côté Pi.

Par exemple dans :

~/.pi/agent/models.json

j’utilise notamment :

{
  "contextWindow": 32768,
  "maxTokens": 4096
}

Il est important de comprendre que modifier uniquement contextWindow dans Pi ne suffit pas.

La vraie limite est définie côté llama.cpp.

4. Installer Pi Coding Agent

Dans WSL :

npm install -g @mariozechner/pi-coding-agent

Puis :

pi --version

Et dans un projet :

cd ~/mon-projet
pi

5. Configurer Bonsai dans Pi

Pi peut utiliser un provider compatible OpenAI.

Le fichier se trouve ici :

~/.pi/agent/models.json

Exemple de configuration :

{
  "providers": {
    "bonsai": {
      "baseUrl": "http://localhost:8081/v1",
      "api": "openai-completions",
      "apiKey": "dummy",
      "models": [
        {
          "id": "/home/yvonh/Bonsai-demo/models/bonsai2-gguf/27B/Ternary-Bonsai-2-27B-PQ2_0.gguf",
          "name": "Bonsai 2 27B Local",
          "reasoning": false,
          "contextWindow": 32768,
          "maxTokens": 4096,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}

Ensuite, dans Pi :

/model

et il suffit de sélectionner :

Bonsai 2 27B Local

6. Pourquoi Pi plutôt qu’Aider dans mon cas

Aider fonctionne très bien pour modifier du code, mais son fonctionnement repose surtout sur un protocole d’édition.

Pi correspond davantage à ce que je cherchais : un agent capable d’utiliser des outils.

Il peut notamment :

  • lire les fichiers
  • inspecter le projet
  • lancer des commandes shell
  • utiliser git
  • lancer des tests
  • modifier des fichiers
  • observer le résultat
  • continuer son travail

Le fonctionnement ressemble davantage à :

LLM
 ↓
appel d’un outil
 ↓
résultat
 ↓
nouvelle décision
 ↓
nouvel appel d’outil

C’est beaucoup plus proche de l’expérience Codex CLI ou Claude Code.

7. Le script que j’utilise

Pour éviter de retaper toute la commande llama.cpp, j’ai créé :

~/start-bonsai.sh

avec ce contenu :

#!/bin/bash

LLAMA_SERVER="/home/yvonh/Bonsai-demo/bin/cuda/llama-server"
MODEL="/home/yvonh/Bonsai-demo/models/bonsai2-gguf/27B/Ternary-Bonsai-2-27B-PQ2_0.gguf"

CTX_SIZE=32768

while [[ $# -gt 0 ]]; do
  case "$1" in
    --ctx)
      CTX_SIZE="$2"
      shift 2
      ;;
    *)
      echo "Option inconnue : $1"
      echo "Usage: $0 [--ctx taille]"
      exit 1
      ;;
  esac
done

"$LLAMA_SERVER" \
  -m "$MODEL" \
  --ctx-size "$CTX_SIZE" \
  --port 8081

Puis :

chmod +x ~/start-bonsai.sh

Je peux maintenant lancer Bonsai simplement :

~/start-bonsai.sh

avec 32768 tokens par défaut.

Ou choisir une autre taille :

~/start-bonsai.sh --ctx 65536

8. Workflow final

Mon workflow est maintenant très simple.

Premier terminal :

~/start-bonsai.sh --ctx 32768

Deuxième terminal :

cd ~/mon-projet
pi

Puis je sélectionne Bonsai dans :

/model

J’obtiens ainsi un agent de code local fonctionnant avec un modèle GGUF, llama.cpp et Pi directement dans WSL.

Conclusion

La combinaison qui fonctionne bien pour moi est :

Bonsai 27B GGUF
        ↓
    llama.cpp
        ↓
API OpenAI compatible
        ↓
Pi Coding Agent
        ↓
fichiers / shell / git / tests

Le point le plus important à retenir concerne la fenêtre de contexte.

Si Pi annonce 32k mais que llama.cpp tourne encore avec 16k, les requêtes échoueront dès que le contexte devient trop gros.

Il faut donc garder les deux configurations cohérentes :

llama.cpp : --ctx-size 32768
Pi        : contextWindow 32768
Pi        : maxTokens 4096

Avec cette configuration, j’ai pu utiliser mon Bonsai local comme véritable agent de développement dans WSL.

Le harness de Pi minimaliste

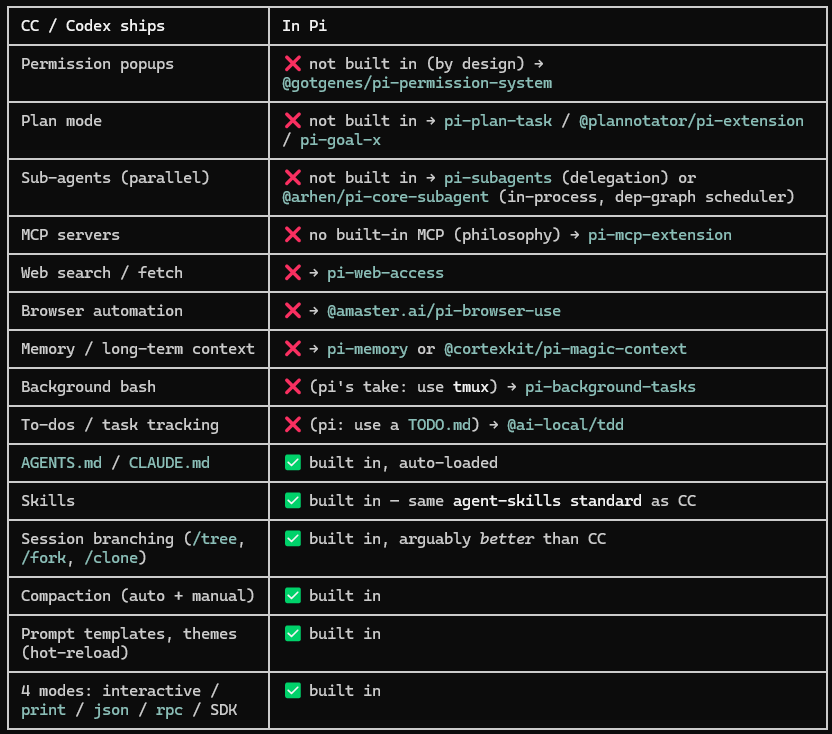
En vert ce qui vient avec Pi par défaut, j’ai demandé une liste d’extensions à installer pour arriver au niveau de Codex ou Claude Code.

 Copy-paste bootstrap (install order)

 Essentials — to feel like CC:

 ```bash
   pi install npm:@gotgenes/pi-permission-system   # permission gates
   pi install npm:pi-subagents                     # sub-agent delegation / multi-agent
   pi install npm:pi-mcp-extension                 # MCP (connect any MCP server)
   pi install npm:pi-web-access                    # web search / fetch / repo clone
   pi install npm:pi-memory                        # cross-session memory
 ```

 Plan mode (pick one):

 ```bash
   pi install npm:pi-plan-task                     # configurable, approved, resumable
   # OR pi install npm:@plannotator/pi-extension   # interactive plan review w/ annotations
 ```

 Make it look/feel like CC (UI polish):

 ```bash
   pi install npm:@zigai/pi-footer                 # compact status line
   pi install npm:pi-claude-code-tui               # polished CC-style startup header
   pi install npm:@zigai/pi-response-renderer      # more compact responses
 ```

 Then browse the whole ecosystem in-session with /pi-resource-center (if that resolves for
 you) or the npm search (https://www.npmjs.com/search?q=keywords%3Api-package) / Discord.

 Config wiring

 ```bash
   # System prompt (replace or append) — project + global
   echo "Your project conventions here." > .pi/SYSTEM.md
   echo "Global defaults" > ~/.pi/agent/SYSTEM.md
   # APPEND_SYSTEM.md appends instead of replacing.

   # Context/instructions (auto-loaded from cwd + parents + global)
   # project:  ./AGENTS.md        global:  ~/.pi/agent/AGENTS.md

   # Skills — same folder standard as CC, so existing skills usually drop in
   # project:  .pi/skills/        global:  ~/.pi/agent/skills/
   # also:     ~/.agents/skills/  (shared w/ other harnesses)

   # Settings: /settings, or edit
   # ~/.pi/agent/settings.json   (global)
   # .pi/settings.json           (project, overrides)
 ```

 You already have ~/.pi/agent/models.json set up with your local Bonsai provider, so no auth
 work needed.

 Two honest caveats for your setup

 1. Security — pi packages run with full system access and execute arbitrary code (the README
 says this explicitly). This is especially important for pi-permission-system, which is
 what's actually gating what your model can run. I'd review the source of anything you
 install before you do. I can pull a package's source and skim it for you first.
 2. Your model — you're currently on a local Bonsai 27B (16k context, no reasoning, no
 developer-role). The harness features all work fine with it, but the "smart" parts —
 plan-mode completion auditors, sub-agent orchestration, heavy compaction — shine with a
 bigger cloud model (Claude/OpenAI). If you plan to run those workflows, add an
 ANTHROPIC_API_KEY or OPENAI_API_KEY and /login so you can cycle models per-task.

 Want me to install the essentials now, and/or pull the source of pi-permission-system and
 pi-subagents and give you a quick security skim before you trust them with your shell?

A part l’orchestration d’agents, parce que j’ai un model LLM local moins puissant que Claude ou Codex, les plugins fonctionnent sur mon poste. On peut installer l’orchestration d’agent à condition d’jouter les API KEY de Claude et Codex (utiliser les LLM via API KEY sont plus cher que d’utiliser via son compte).

N’utilisez pas un agent IA avant d’avoir été au bout avec le LLM

Je suis tombé sur un tweet de Andrej Karpathy qui m’a fait réfléchir sur quand commencer à orchestrer des agents (la plupart du temps c’est prématuré)

Lorsque Andrej Karpathy parle de « understand the model underneath first », il ne dit pas qu’il faut connaître les équations des transformeurs ou être chercheur en IA. Il veut dire qu’avant de construire des agents sophistiqués, il faut comprendre ce que sait réellement faire un LLM, ses limites et la manière de le piloter efficacement.

En d’autres termes, il faut maîtriser le modèle de base avant de construire une architecture complexe autour de lui.

1. Comprendre ce qu’un LLM sait faire naturellement

Un modèle de langage moderne est déjà capable de nombreuses tâches sans nécessiter d’agent :

  • Résumer un document.
  • Écrire du code.
  • Expliquer un concept.
  • Transformer un texte.
  • Extraire des informations.
  • Planifier une suite d’actions.
  • Générer du contenu structuré.

Beaucoup de développeurs créent aujourd’hui des architectures comportant plusieurs agents, alors qu’un simple prompt bien conçu adressé à GPT-5 ou Claude permettrait d’obtenir le même résultat. ET je ne vous dis pas ce que ça vous coûte en tokens !

L’objectif est donc de connaître les capacités natives du modèle avant d’ajouter des couches de complexité.

2. Connaître les limites du modèle LLM

Un bon développeur d’agents doit également connaître les faiblesses du modèle.

Par exemple :

  • Il peut halluciner lorsqu’il manque d’informations.
  • Il oublie progressivement une partie du contexte lorsque celui-ci devient très long.
  • Il est sensible à la formulation des instructions.
  • Certains modèles sont meilleurs pour le raisonnement, d’autres pour le code ou la rédaction.
  • Les performances évoluent fortement d’une version à l’autre.

Très souvent, lorsque l’on pense que « l’agent fonctionne mal », le véritable problème provient du modèle sous-jacent.

3. Savoir guider le modèle

Avant d’investir du temps dans un framework d’agents, il est essentiel de maîtriser les techniques permettant d’exploiter pleinement un LLM.

Parmi elles :

  • Le prompt engineering.
  • Les instructions système.
  • Les sorties structurées (JSON, XML…).
  • Le few-shot prompting.
  • Le function calling.
  • La gestion du contexte.
  • Les techniques de raisonnement lorsqu’elles sont appropriées.

Selon Karpathy, une bonne maîtrise de ces mécanismes permet déjà de résoudre une très grande partie des problèmes rencontrés.

4. Comprendre le coût réel des agents

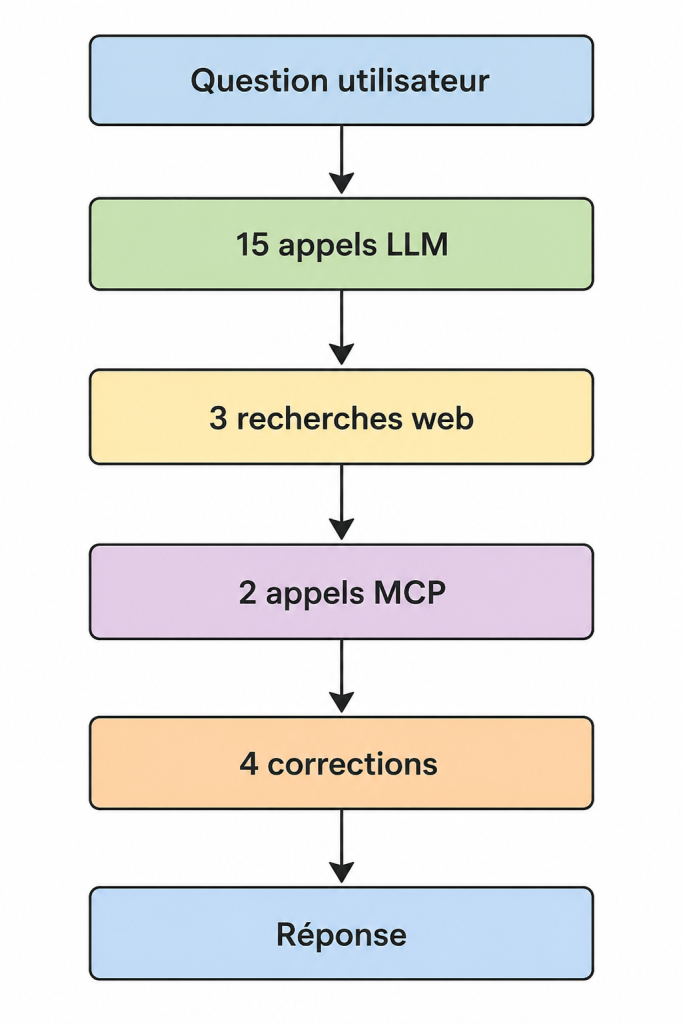
Un agent complexe peut facilement exécuter une séquence comme celle-ci :

Dans certains cas, un prompt mieux conçu permettrait d’obtenir le même résultat en un ou deux appels seulement.

Avant d’ajouter des agents, il est donc important de se demander si la tâche nécessite réellement une orchestration complexe.

5. Comprendre les capacités émergentes

L’un des messages importants de Karpathy est que les capacités des modèles progressent très rapidement.

Ce qui nécessitait plusieurs agents hier peut devenir une simple capacité native demain.

Par exemple :

En 2023 voilà comment fonctionnait un LLM

Les progrès du modèle rendent progressivement inutiles certaines architectures multi-agents qui semblaient indispensables auparavant.

Pourquoi Karpathy évoque-t-il OpenAI ?

Il fait référence à une tendance observée dans les débuts de la recherche en IA.

À cette époque, beaucoup d’efforts étaient consacrés à la construction de systèmes complexes :

  • planificateurs ;
  • orchestrateurs ;
  • mémoires sophistiquées ;
  • architectures d’agents.

Or les plus grandes avancées sont finalement venues de l’amélioration du modèle fondamental :

  • davantage de données ;
  • davantage de puissance de calcul ;
  • meilleure architecture (Transformer) ;
  • meilleures méthodes d’entraînement ;
  • lois de scaling.

Une fois le modèle devenu suffisamment performant, une grande partie des mécanismes complexes n’était plus nécessaire.

Et c’est exactement en phase avec ce que je dis plus haut au début de cet article. Quand vous n’avez pas encore exploité à fond un LLM, c’est pas la peine de faire des orchestrations inutilement.OpenAI, à très tôt, avant d’avoir pu exploiter à fond un LLM, ce qui est normal puisque les LLM n’étaient encore perfectibles. Ils avaient commencé à faire des orchestrations d’agents en voulant améliorer les résultats mais en fait ils sont allés dans des complications vraiment très grandes.

De cette expérience, il en a tiré qu’il faut exploiter un LLM jusqu’au bout. Et c’est seulement quand il montre ses limites que vous allez vers l’orchestration d’agents. Pas avant.

Alors développeur quand allez vous faire de l’orchestration comme tonton Boris?

Les frameworks d’agents deviennent réellement intéressants lorsque le problème nécessite :

  • des tâches longues ;
  • plusieurs outils externes ;
  • une mémoire persistante ;
  • une orchestration complexe ;
  • des validations indépendantes ;
  • des processus asynchrones.

Conclusion

Un agent n’est qu’une couche d’orchestration autour d’un LLM.

Si le modèle est mal compris ou mal exploité, ajouter davantage d’agents ne fera qu’augmenter la complexité, les coûts et les risques d’erreur.

À l’inverse, lorsqu’on maîtrise parfaitement les capacités du modèle sous-jacent, il devient beaucoup plus facile de savoir quand un agent est réellement nécessaire et quand un simple appel au LLM est largement suffisant.

Je trouve que le terme de prompt engineer n’est finalement pas si futile que ça !

Coder sur son PC depuis son téléphone avec Claude Code

Objectif

Utiliser Claude Code installé sur un PC Windows depuis un téléphone Android (ConnectBot) via SSH. On va dans un premier temps

1. Trouver le nom du PC

Dans l’invite de commande :

hostname

Exemple :

PCYVON2

2. Trouver le nom d’utilisateur Windows

Dans l’invite de commande :

whoami

Exemple :

PCYVON2\yvonh

Le login SSH est donc :

yvonh

3. Trouver l’adresse IP du PC

Dans l’invite de commande :

ipconfig

Repérer l’adresse IPv4 :

192.168.1.xxx

Depuis ConnectBot :

ssh yvonh@192.168.1.xxx

Il est préférable d’utiliser l’adresse IP plutôt que le nom du PC.

4. Vérifier si le serveur SSH est installé

Dans PowerShell :

Start-Service sshd

Si l’erreur suivante apparaît :

Impossible de trouver un service assorti du nom « sshd »

cela signifie que OpenSSH Server n’est pas installé.

5. Installer le serveur OpenSSH

Ouvrir PowerShell en administrateur

Si le message suivant apparait :

Get-WindowsCapability :
L’opération demandée nécessite une élévation.

indique que PowerShell n’a pas été lancé avec les droits administrateur.

Procédure :

  • Menu Démarrer
  • Rechercher PowerShell
  • Clic droit
  • Exécuter en tant qu’administrateur

6. Vérifier les composants OpenSSH

Dans PowerShell administrateur :

Get-WindowsCapability -Online |
Where-Object Name -like 'OpenSSH*'

Exemple :

OpenSSH.Client~~~~0.0.1.0     Installed
OpenSSH.Server~~~~0.0.1.0     NotPresent

7. Installer OpenSSH Server

Add-WindowsCapability -Online -Name OpenSSH.Server~~~~0.0.1.0

8. Démarrer le service SSH

Start-Service sshd

Le rendre automatique :

Set-Service -Name sshd -StartupType Automatic

Vérifier que c’est lancé :

Get-Service sshd

Résultat attendu :

Status : Running

9. Vérifier le Firewall

Par précaution on vérifie que le firewall ne viennent pas gêner :

Get-NetFirewallRule -Name *ssh*

Si aucune règle n’existe :

New-NetFirewallRule `
    -Name sshd `
    -DisplayName "OpenSSH Server" `
    -Enabled True `
    -Direction Inbound `
    -Protocol TCP `
    -Action Allow `
    -LocalPort 22

10. Tester localement

Depuis le PC :

ssh yvonh@localhost

Si le serveur fonctionne, Windows demande le mot de passe du compte.

11. Connexion depuis ConnectBot

Host :

192.168.1.xxx

Login :

yvonh

Port :

22

Commande SSH :

ssh yvonh@192.168.1.xxx

Cas réseau

Fonctionne

Internet Box
      │
 ┌────┴─────┐
 │          │
PC Ethernet Téléphone Wi-Fi
192.168.1.42
192.168.1.55

Le PC peut être en Ethernet et le téléphone en Wi-Fi tant qu’ils sont connectés à la même box.

Ne fonctionne pas directement depuis un opérateur mobile

Dans ce cas, il faut utiliser une solution comme Tailscale, WireGuard ou ouvrir un accès SSH sécurisé.

Alternatives gratuites à Termius

Termius est une superbe application, mais il peut couter cher, c’est sur abonnement mensuel et non payable en une fois. Néanmoins il existe comme toujours des alternatives gratuites. Pour ma part j’utilise ConnectBot.

Android

  • ConnectBot (Open Source)
  • JuiceSSH
  • Material Terminal

iPhone

  • WebSSH
  • a-Shell

Architecture recommandée

Téléphone
      │
ConnectBot
      │
SSH
      │
PC Windows
      │
Claude Code

Ou, encore mieux : Utiliser Tmux ! j’adore cet outil, il permet de récupérer une session quand vous fermez votre ordinateur.

Téléphone
      │
ConnectBot
      │
SSH
      │
VPS
      │
tmux
      │
Claude Code

Cette architecture permet de laisser Claude Code travailler même lorsque le téléphone est verrouillé ou déconnecté.

Les élèves à l’ère des saas et de l’IA

Le code n’est plus l’élément central dans la vie du développeur

aujourd’hui, le code est devenu une commodité, même quelqu’un qui ne sait pas coder peut demander à une IA de coder pour lui.

Le développeur nouvelle mouture, n’a plus à se soucier de coder à la main toutes les lignes. Mais alors que doit faire un développeur? s’il ne code plus que doit il faire?

Le code est une tâche technique très bien cadrée par l’IA

Avec les progrès des LLM, coder devient de plus en plus une activité dévolue à l’IA. Le développeur, loin de chômer doit s’attaquer à d’autres front. En effet, aujourd’hui je délègue 100% du design front end au LLM. J’interviens en amont, lors de la modélisation du logiciel, et encore je me fais aider par l’IA. Pourquoi? je pense tout simplement c’est l’envie de voir rapidement le résultat. Mais attention je ne dis pas que c’est ce qu’on doit faire.

Que devient le développeur? et surtout le développeur junior?

Aujourd’hui, je planifie beaucoup, tout seul, en peu de temps, autant vous dire que je ne fais pas les choses de façon idéale. Je me mets comme mission d’améliorer ce type de travail, en faisant ce que ne je ne faisais jamais : passer plus de temps sur le cahier des charges. Avant j’avais une idée globale assez claire et je codais directement sur mon IDE. Le MCD? c’est sur une feuille de papier, les tables je les faisais à la main. Pas de test unitaire, pas le temps. Je me rends compte que quand le logiciel appartient à une certaines typologie de logiciel, il faut absolument prendre une méthode de conception logicielle, en passant du temps sur les spécifications que l’IA doit respecter.

Je dois même parler d’agent maintenant pour subdiviser le travail, paralléliser, faire collaborer les agents. Ainsi un agent viendra contrôler le respect des spécifications du code produit par un autre agent. Tout ceci s’explique par le fait que l’agent de code peut vous rendre une travail bâcler malgré un prompt clair. Vous ne devez jamais assumer que l’IA fait un travail correct, il faut le challenger.

Marché de l’emploi développeur web en 2026 en situation délicate

Le travail du développeur est chamboulé, et beaucoup de gens sont en perte de repère actuellement, on a peur que l’IA nous remplace, tellement il est bon dans le code, pour autant beaucoup de sociétés ne sont pas encore passées à l’IA agentique.

J’ai envie de voir le verre à moitié plein

En tant qu’entrepreneur, j’ai tendance à voir le bon côté des chose, à être optimiste. Bien sûr l’IA à un impact direct sur le taux d’emploi des junior, mais pas aussi exagéré que certains vendeurs de solution LLM le disent(n’est pas Anthropic ?)

Les bon points : le junior peut faciliter son onboarding beaucoup plus facilement qu’avant. Jadis la période la plus redoutée est la période d’essais, on nous donne des bugs à corriger, de plus en plus ardus afin qu’on monte en compétence graduellement. Mais malgré cela, ça peut être stressant, on a peur de ne pas pouvoir résoudre un bug.

Présentation de Pi le harness pour modèle LLM

Pourquoi les “AI harness” deviennent plus importants que les modèles eux-mêmes

Depuis quelques mois, un nouveau terme revient partout dans l’écosystème IA : le “harness”. Derrière ce mot un peu technique se cache pourtant une idée centrale dans l’évolution des agents IA modernes. Et parmi les projets qui cristallisent cette tendance, il y a Pi.

Pi se présente comme un “minimal terminal coding harness”. Dit autrement : une couche logicielle légère qui transforme un modèle de langage en véritable agent opérationnel.

Le point important, c’est que Pi ne cherche pas à être un simple chatbot. Son rôle est d’orchestrer le travail du modèle : accès aux fichiers, exécution de commandes, gestion du contexte, historique, extensions, workflows, mémoire, outils externes, etc.

Et aujourd’hui, c’est précisément cette couche d’orchestration qui devient stratégique.

Qu’est-ce qu’un harness IA exactement ?

Un modèle comme GPT-5, Claude ou Gemini sait générer du texte. Mais seul, il ne “fait” presque rien.

Le harness est la structure qui entoure le modèle pour lui permettre d’agir :

  • lire et modifier des fichiers ;
  • lancer des commandes shell ;
  • gérer des sessions ;
  • mémoriser un contexte ;
  • appeler des outils ;
  • changer de modèle dynamiquement ;
  • appliquer des règles de sécurité ;
  • orchestrer plusieurs étapes de travail.

Sur Reddit et dans les communautés open source, beaucoup résument le harness comme “le système qui transforme un LLM en agent”.

En pratique, le modèle devient le moteur, mais le harness devient le systèm d’exploitation.

Pourquoi Pi attire autant l’attention ?

Pi adopte une approche radicalement minimaliste. Là où beaucoup d’outils IA deviennent des “IDE géants”, Pi veut rester petit au cœur et extensible autour.

Le projet fournit seulement quelques primitives essentielles :

  • read
  • write
  • edit
  • bash

Puis tout le reste est construit via des extensions TypeScript, des templates, des skills ou des packages.

Cette philosophie est importante car elle inverse la logique habituelle :

au lieu d’imposer un workflow au développeur, Pi laisse le développeur construire son propre workflow.

C’est une différence majeure avec des solutions plus fermées comme OpenAI Codex, Anthropic Claude Code ou certains IDE IA très intégrés.

Pourquoi le harness compte parfois plus que le modèle ?

C’est probablement le point le plus sous-estimé aujourd’hui.

Beaucoup pensent encore que toute la valeur vient du LLM. En réalité, deux équipes utilisant exactement le même modèle peuvent obtenir des résultats radicalement différents selon le harness utilisé.

Pourquoi ?

Parce qu’une énorme partie de la performance agentique dépend de :

  • la gestion du contexte ;
  • les outils disponibles ;
  • la mémoire ;
  • la capacité à découper les tâches ;
  • la sécurité ;
  • le routage entre modèles ;
  • les prompts système ;
  • les boucles de validation ;
  • les workflows d’exécution.

Pi insiste justement sur cette idée de “context engineering”.

Aujourd’hui, un bon harness peut parfois compenser un modèle plus faible.

À l’inverse, un excellent modèle mal orchestré produit souvent des agents incohérents, coûteux ou instables. Cela ramène à la discussion de l’importance du contexte, et cela a toujours été depuis le début, rien de nouveau. Même quand vous promptez l’IA sur le web, vous définissez un bon contexte pour que la réponse soit la plus précise, et le prompt engineering des début s’appuyait sur la maitrise du prompt (une abondante littérature sur les différentes technique de prompting existe, à mon avis inutile de s’embarasser des dizaines et des dizaines de technique c’est du marketing)

Quels autres harness existent ?

Pi n’est pas seul.

On voit émerger plusieurs familles de harness IA :

OpenCode, OpenHands, Continue.dev,Cline,Cursor,OpenClaw

Chaque projet fait des choix différents :
minimalisme, autonomie, sandboxing, multi-agents, mémoire persistante, IDE intégré ou CLI terminal.

Le marché semble d’ailleurs évoluer vers une commoditisation des modèles eux-mêmes. Les différences entre GPT, Claude, Gemini ou Qwen se réduisent progressivement sur certaines tâches.

Le véritable avantage compétitif se déplace donc vers :

  • le harness ;
  • les workflows ;
  • les outils ;
  • l’intégration ;
  • l’expérience développeur.

Autrement dit : le futur des agents IA ne se jouera pas uniquement sur “quel modèle utiliser”, mais surtout sur “comment le piloter”.

Comment installer llama.cpp le moteur d’inférence open source et gratuit

Je vous avais parlé de Ollama, par le passé, mais Ollama utilise un moteur d’inférence qui est llama.cpp, le vrai; Ollama n’est qu’une interface visuelle construite par dessus llama.cpp .

Et pour des questions d eperformance, je vous conseille de le prendre plutôt que d’utiliser Ollama qui est plutôt pour un public larger. Entant que codeur, il faut utilise llama.cpp.

Installation de llama.cpp

Allez d’abord le télécharger, en ce qui me concerne je suis sous Windows, donc je vais utiliser WSL. Il faut le savoir en matière d’intelligence artificielle il vaut mieux utiliser Linux.

Il existe plein de sites qui permettent de le télécharger, la source officielle de llama.cpp, mais aussi ce site qui explique bien comment il faut faire pour installer llama.cpp.

Installer llama.cpp n’est que la première partie du travail, il faudra après son installation télécharger les modèles LLM opensource.

Il y a 2 options pour installer llama.cpp sous Windows, la première option nécessite d’avoir Visual Studio (et non VS Code), la seconde pour moi est plus simple , est d’installer sous WSL ce qui nous ramène à un système Linux (souvenez vous en matière d’IA Linux est bien mieux).

On part sur l’option 2 avec WSL, si vous ne l’avez pas encore installé :

wsl --install

Puis:
sudo apt update
sudo apt install git build-essential cmake

puis clonez le projet llamacpp:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp

cmake -B build
cmake --build build

puis attendez un moment (le processus de compilation est assez lent)
Voilà vous êtes prêt maintenant !

Les modèles LLM GGUF

Ce sont des modèles faits pour tourner en local, Hugging Face en héberges milliers de tous type : textuel, image, vidéo.

Vous devez avoir une carte graphique au minimum de 8GB de VRAM, ce qui vous permet d’avoir des modèles génératifs qui tiennent un peu la route. Moi j’ai une carte de 16 GB, donc je peux avoir des modèles un peu plus grand. Mais alors il faut s’attarder sur la notion de paramètre dans les modèles LLM. Plus le nombre de paramètres est grand plus le modèle est performant normalement.

Les modèles LLM non GGUF, les modèles d’origine qui tournent dans les info cloud sont au format .safetensors, .bin ou .pth. Il faut beaucoup de VRAM (volatil RAM la RAM des cartes graphique à la différence de la RAM du CPU)pour les faire tourner. La configuration est plus complexe avec des ichier config/tokenizer, setup CUDA pénible parfois.

Le format GGUF résout tous ces problèmes ça tombe bien pour nous c’est plus facile à mettre en oeuvre. Un modèle LLM de 500B (500 milliards de paramètre en 8 bits) nécessite 550 giga de RAM. Nous on va faire tourner des modèle 8 bits plus petits, à 8B, 12B, en 8 bits, donc ma carte 5060 à 16GB de VRAM suffit.

Pour savoir combien de Giga de VRAM il faut pour faire tourner un modèle 8bit, 1 milliard (1B B comme billions milliard en anglais) de paramètre nécessite 1 giga de VRAM. Il existe des modèle dégradé en 4 bits, dit des modèle quantizé, en passant de 8 bits à 4 bits, on divise par deux la taille des modèle, donc ma carte de 16 GB de VRAM peut faire tourner un modèle 32B en 4 bits.

Les modèles quantizés sont moins performant mais pas de moitié, en passant de 8 bits à 4 bit, on dégrade de 30% les performances d’inférence.

GGUF met dans un seul fichier les poids du modèle, le tokenizer, les metadatas, et paramètres d’inférence dans un seul fichier, c’est plus facile à mettre en oeuvre. Voir cet article plus en détail sur ces propriétés dans le GGUF.

Télécharger un modèle LLM

Si vous avez suivi l’installation dans WSL, votre installation de llama.cpp doit se trouver dans le répertoire suivant :

/mnt/c/Users/<user>/llama.cpp/build/bin/

et dans ce répertoire vous avez llama-cli, et llama-server

Il est conseillé d'installer huggingface-hub

pip install huggingface-hub

et ensuite on télécharge un fichier GGUF (le LLM), avec 16 GB un des meilleur modèle est celui de Mistral 7B, c'est un peu décevant mais si on télécharge un modèle plus grand que la VRAM (16GB), ça plante :$

Mais avant on vérifie que python et pip sont bien  ceux de WSL

which python3
which pip3

si l'une des commande retourne */pyenv-win/* dans le chemin, c'est qu'on n'est pas 100% Linux, dans mon cas c'était pip qui était pas Linux, mais Python était bien Linux

on doit faire cette commande pour installer pip :
python3 -m pip install huggingface-hub --break-system-packages

si la lligne ci-dessus ne marche pas il faut installer pip

sudo apt install python3-pip

puis refaire :
python3 -m pip install huggingface-hub --break-system-packages


Téléchargement du modèle Mistral

Vérifiez que le répertoire ~/models existe sinon faite
mkdir -p ~/models


wget https://huggingface.co/bartowski/Mistral-7B-Instruct-v0.3-GGUF/resolve/main/Mistral-7B-Instruct-v0.3-Q8_0.gguf \
  -O ~/models/mistral-7b-q8.gguf

Ensuite une fois installé lancez :

~/llama.cpp/build/bin/llama-server \
  -m ~/models/mistral-7b-q8.gguf \
  -c 4096 \
  --port 8080

Et dans un autre terminal faites :
curl http://localhost:8080/health

vous devriez avoir en réponse :
{"status":"ok"}

Comment fait on pour avoir une interface friendly?

Il va falloir installer par exemple OpenWebUI, mais je trouve que c’est plus facile d’installer OpenWebUI dans un Docker aussi, je suppose que vous avez installé Docker Desktop:

docker run -d \
  --name open-webui \
  --add-host=host.docker.internal:host-gateway \
  -e OPENAI_API_BASE_URL=http://host.docker.internal:8080/v1 \
  -e OPENAI_API_KEY=fake \
  -p 3000:8080 \
  ghcr.io/open-webui/open-webui:main

Ensuite on ouvre le navigateur au http://localhost:3000  (il faut avoir lancé llama-server.

une fosi le docker en place
docker logs open-webui
pour le monitorer, quand on voit Uvicorn running, on ouvre sur l'hôte http://localhost:3000

Les caractéristiques d’un modèle GGUF

Les poids d’un modèle

C’est le cerveau appris du LLM.

Pendant l’entraînement, le modèle apprend des milliards de paramètres numériques (des matrices de nombres flottants).

vecteur stockant les nombre
[0.2381, -1.442, 0.882]

Un modèle 7B contient 7 milliards de ces paramètres, un modèle 70B contient 70 milliards de ces paramètres ….

Ces poids servent dans les couches du transformer :

embedding
attention
feed forward layers
output layers

Lorsqu’on écrit dans le prompt un texte comme « Bonjour comment vas tu? » ce que fait llama.cpp :

  • transforme le texte en tokens
  • fait passer ces tokens dans les couches du réseau de neurones
  • applique les poids à chaque étape
  • prédit le token suivant

Les poids sont stockés sous forme de tensors dans GGUF

blk.0.attn_q.weight
blk.0.attn_k.weight
blk.0.ffn_up.weight

./llama-cli -m model.gguf

la commande ci-dessus li les tensors en mémoire RAM/VRAM

Tokenizer

Le LLM ne comprend pas le texte brut, mais les token, docn il faut tokenizer les textes.

"Bonjour tout le monde" peut devenir
[5321, 884, 921]

Le tokenizer définit

  • le vocabulaire
  • le mapping texte-> id
  • le mapping id -> texte
./llama-cli -m model.gguf -p "hello"

llama.cpp tokenize "hello"
envoit les ids au modèle
reçoit des ids du model
reconvertit en texte

Metadatas

Une metadata est une données sur la données, dans notre cas, c’est la carte d’identité du modèle

architecture
nombre de couches
taille contexte
type de modèle
version tokenizer
quantization utilisée

Exemple:
architecture = llama
context_length = 8192
embedding_length = 4096
block_count = 32

La commande
./llama-cli -m model.gguf
sort ces données à l'écran

Paramètres d’inférence

Ce ne sont PAS les poids entraînés. Ce sont les réglages au moment où tu fais générer du texte.

./llama-cli \
  -m model.gguf \
  --temp 0.7 \
  --top-k 40 \
  --top-p 0.9

Température

Controle l’aléatoire, plus c’est élevé (proche de 1) plus c’est créatif

top-k

Le modèle garde uniquement les K tokens les plus probables.

top-k = 40   choisit parmi les 40 meilleurs candidats

top-p

Il garde les tokens jusqu’à atteindre X% de probabilité cumulée.

contexte size

C’est la fenêtre de contexte, la mémoire du LLM.

En résumé :

  • poids = connaissances du modèle
  • tokenizer = traduction texte ↔ tokens
  • metadata = mode d’emploi du modèle
  • paramètres d’inférence = réglages runtime dans llama.cpp

Comment sont les modèle avant quantization?

Le standard d’origine est sur 16 bits FP16. La majorité des modèles open source sont entrainés et distribués en

  • FP16 16-bit floatingpoint
  • parfois en BF16 (bfloat 16) surtout en entrainement

Ainsi en ordre de grandeur, un modèle LLM 7B en FP16 nécessite 14 Go (7B x 16 bits ou 2 bytes), un modèle 70B nécessite en FP16 nécessite 140 Go, 70 Go en 8 bits, et 35 Go en 4bits, cette dernière quantization est intéressante, car elle met à notre portée des modèle 70B pour du matériel comme la RTX 3090 (24 GB de VRAM), il faut 2 carte graphique et ça fera 48 GB de VRAM.

Modèle dense VS modèle sparse (mixture of Experts)

Dans le contexte des LLM locaux avec llama.cpp, la différence est surtout : combien de paramètres sont réellement utilisés à chaque token généré.

Les modèles denses

Ce sont les modèles classiques, Mistral, Llama, Qwen, à chaque prompt chaque token passe par toutes les couches et tous les paramètres concernés. Sur un modèle à 7B de paramètres, presque les 7 milliards de paramètre sont sollicités théoriquement (hors optimisation).

Les mixture of experts (MoE)

Le modèle contient plusieurs experts, tous ne sont pas activés en même temps, cela dépend du prompt un routeur choisit quels experts utiliser selon le token. Exemple le modèle Mistral AI Mixtral 8x7B. Théoriquement ce modèle a 56B paramètres, seul12 à 14B sont actifs par token.

Le MoE est intéressant en local car le coput d’inférence est plus bas qu’un modèle dense équivalent. Ainsi le coput d’un 56B est en fait celui d’un 12 ou 14B/

Mais attention vous devez charger tous els poids en VRAM. Qu’est ce qu’on y gagne alors? On y gagne en vitesse de calcul relative, intelligence et capacité, mais la taille on n’y gagne pas.

Comment faire d’Obsidian votre second cerveau ?

Je suppose que vous avez installé Obsidian

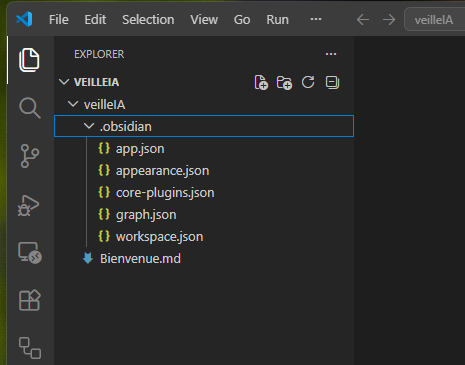
Démarrez Obsidian, commencez par créer un coffre (vault en anglais), liez le coffre à un répertoire. Pour ma part je choisis VeilleIA.

Ouvrez pour ce tutoriel le dossier VeilleIA pour voir les fichier sui sont automatiquement créés

Ensuite depuis le terminal de VScode ou directement dans un terminal à l’endroit où se trouve le répertoire VeilleIA.

Initialisation du wiki augmenté à Claude

Copie de la méthode détaillé pour faire de Obsidian votre second cerveau. Andrej Karpathya écrit un texte très populaire où il se sert de Obsidian et des ses fichier markdown comme mémoire de LLM (claude ici en particuliers). Le problème majeur des LLM est qu’ils n’ont pas de mémoire, il faut leur rappeler souvent le contexte. Disposer d’un ensemble de fichier LLM en guise de mémoire est très intéressant, pour avoir un bon assistant IA.

Son texte se trouve ici. Nous allons copier ce texte où il décrit sa méthode et le donner à manger à Claude. Cliquez sur raw en haut à droite pour avoir le bon texte.

# LLM Wiki

A pattern for building personal knowledge bases using LLMs.

This is an idea file, it is designed to be copy pasted to your own LLM Agent (e.g. OpenAI Codex, Claude Code, OpenCode / Pi, or etc.). Its goal is to communicate the high level idea, but your agent will build out the specifics in collaboration with you.

## The core idea

Most people's experience with LLMs and documents looks like RAG: you upload a collection of files, the LLM retrieves relevant chunks at query time, and generates an answer. This works, but the LLM is rediscovering knowledge from scratch on every question. There's no accumulation. Ask a subtle question that requires synthesizing five documents, and the LLM has to find and piece together the relevant fragments every time. Nothing is built up. NotebookLM, ChatGPT file uploads, and most RAG systems work this way.

The idea here is different. Instead of just retrieving from raw documents at query time, the LLM **incrementally builds and maintains a persistent wiki** — a structured, interlinked collection of markdown files that sits between you and the raw sources. When you add a new source, the LLM doesn't just index it for later retrieval. It reads it, extracts the key information, and integrates it into the existing wiki — updating entity pages, revising topic summaries, noting where new data contradicts old claims, strengthening or challenging the evolving synthesis. The knowledge is compiled once and then *kept current*, not re-derived on every query.

This is the key difference: **the wiki is a persistent, compounding artifact.** The cross-references are already there. The contradictions have already been flagged. The synthesis already reflects everything you've read. The wiki keeps getting richer with every source you add and every question you ask.

You never (or rarely) write the wiki yourself — the LLM writes and maintains all of it. You're in charge of sourcing, exploration, and asking the right questions. The LLM does all the grunt work — the summarizing, cross-referencing, filing, and bookkeeping that makes a knowledge base actually useful over time. In practice, I have the LLM agent open on one side and Obsidian open on the other. The LLM makes edits based on our conversation, and I browse the results in real time — following links, checking the graph view, reading the updated pages. Obsidian is the IDE; the LLM is the programmer; the wiki is the codebase.

This can apply to a lot of different contexts. A few examples:

- **Personal**: tracking your own goals, health, psychology, self-improvement — filing journal entries, articles, podcast notes, and building up a structured picture of yourself over time.
- **Research**: going deep on a topic over weeks or months — reading papers, articles, reports, and incrementally building a comprehensive wiki with an evolving thesis.
- **Reading a book**: filing each chapter as you go, building out pages for characters, themes, plot threads, and how they connect. By the end you have a rich companion wiki. Think of fan wikis like [Tolkien Gateway](https://tolkiengateway.net/wiki/Main_Page) — thousands of interlinked pages covering characters, places, events, languages, built by a community of volunteers over years. You could build something like that personally as you read, with the LLM doing all the cross-referencing and maintenance.
- **Business/team**: an internal wiki maintained by LLMs, fed by Slack threads, meeting transcripts, project documents, customer calls. Possibly with humans in the loop reviewing updates. The wiki stays current because the LLM does the maintenance that no one on the team wants to do.
- **Competitive analysis, due diligence, trip planning, course notes, hobby deep-dives** — anything where you're accumulating knowledge over time and want it organized rather than scattered.

## Architecture

There are three layers:

**Raw sources** — your curated collection of source documents. Articles, papers, images, data files. These are immutable — the LLM reads from them but never modifies them. This is your source of truth.

**The wiki** — a directory of LLM-generated markdown files. Summaries, entity pages, concept pages, comparisons, an overview, a synthesis. The LLM owns this layer entirely. It creates pages, updates them when new sources arrive, maintains cross-references, and keeps everything consistent. You read it; the LLM writes it.

**The schema** — a document (e.g. CLAUDE.md for Claude Code or AGENTS.md for Codex) that tells the LLM how the wiki is structured, what the conventions are, and what workflows to follow when ingesting sources, answering questions, or maintaining the wiki. This is the key configuration file — it's what makes the LLM a disciplined wiki maintainer rather than a generic chatbot. You and the LLM co-evolve this over time as you figure out what works for your domain.

## Operations

**Ingest.** You drop a new source into the raw collection and tell the LLM to process it. An example flow: the LLM reads the source, discusses key takeaways with you, writes a summary page in the wiki, updates the index, updates relevant entity and concept pages across the wiki, and appends an entry to the log. A single source might touch 10-15 wiki pages. Personally I prefer to ingest sources one at a time and stay involved — I read the summaries, check the updates, and guide the LLM on what to emphasize. But you could also batch-ingest many sources at once with less supervision. It's up to you to develop the workflow that fits your style and document it in the schema for future sessions.

**Query.** You ask questions against the wiki. The LLM searches for relevant pages, reads them, and synthesizes an answer with citations. Answers can take different forms depending on the question — a markdown page, a comparison table, a slide deck (Marp), a chart (matplotlib), a canvas. The important insight: **good answers can be filed back into the wiki as new pages.** A comparison you asked for, an analysis, a connection you discovered — these are valuable and shouldn't disappear into chat history. This way your explorations compound in the knowledge base just like ingested sources do.

**Lint.** Periodically, ask the LLM to health-check the wiki. Look for: contradictions between pages, stale claims that newer sources have superseded, orphan pages with no inbound links, important concepts mentioned but lacking their own page, missing cross-references, data gaps that could be filled with a web search. The LLM is good at suggesting new questions to investigate and new sources to look for. This keeps the wiki healthy as it grows.

## Indexing and logging

Two special files help the LLM (and you) navigate the wiki as it grows. They serve different purposes:

**index.md** is content-oriented. It's a catalog of everything in the wiki — each page listed with a link, a one-line summary, and optionally metadata like date or source count. Organized by category (entities, concepts, sources, etc.). The LLM updates it on every ingest. When answering a query, the LLM reads the index first to find relevant pages, then drills into them. This works surprisingly well at moderate scale (~100 sources, ~hundreds of pages) and avoids the need for embedding-based RAG infrastructure.

**log.md** is chronological. It's an append-only record of what happened and when — ingests, queries, lint passes. A useful tip: if each entry starts with a consistent prefix (e.g. `## [2026-04-02] ingest | Article Title`), the log becomes parseable with simple unix tools — `grep "^## \[" log.md | tail -5` gives you the last 5 entries. The log gives you a timeline of the wiki's evolution and helps the LLM understand what's been done recently.

## Optional: CLI tools

At some point you may want to build small tools that help the LLM operate on the wiki more efficiently. A search engine over the wiki pages is the most obvious one — at small scale the index file is enough, but as the wiki grows you want proper search. [qmd](https://github.com/tobi/qmd) is a good option: it's a local search engine for markdown files with hybrid BM25/vector search and LLM re-ranking, all on-device. It has both a CLI (so the LLM can shell out to it) and an MCP server (so the LLM can use it as a native tool). You could also build something simpler yourself — the LLM can help you vibe-code a naive search script as the need arises.

## Tips and tricks

- **Obsidian Web Clipper** is a browser extension that converts web articles to markdown. Very useful for quickly getting sources into your raw collection.
- **Download images locally.** In Obsidian Settings → Files and links, set "Attachment folder path" to a fixed directory (e.g. `raw/assets/`). Then in Settings → Hotkeys, search for "Download" to find "Download attachments for current file" and bind it to a hotkey (e.g. Ctrl+Shift+D). After clipping an article, hit the hotkey and all images get downloaded to local disk. This is optional but useful — it lets the LLM view and reference images directly instead of relying on URLs that may break. Note that LLMs can't natively read markdown with inline images in one pass — the workaround is to have the LLM read the text first, then view some or all of the referenced images separately to gain additional context. It's a bit clunky but works well enough.
- **Obsidian's graph view** is the best way to see the shape of your wiki — what's connected to what, which pages are hubs, which are orphans.
- **Marp** is a markdown-based slide deck format. Obsidian has a plugin for it. Useful for generating presentations directly from wiki content.
- **Dataview** is an Obsidian plugin that runs queries over page frontmatter. If your LLM adds YAML frontmatter to wiki pages (tags, dates, source counts), Dataview can generate dynamic tables and lists.
- The wiki is just a git repo of markdown files. You get version history, branching, and collaboration for free.

## Why this works

The tedious part of maintaining a knowledge base is not the reading or the thinking — it's the bookkeeping. Updating cross-references, keeping summaries current, noting when new data contradicts old claims, maintaining consistency across dozens of pages. Humans abandon wikis because the maintenance burden grows faster than the value. LLMs don't get bored, don't forget to update a cross-reference, and can touch 15 files in one pass. The wiki stays maintained because the cost of maintenance is near zero.

The human's job is to curate sources, direct the analysis, ask good questions, and think about what it all means. The LLM's job is everything else.

The idea is related in spirit to Vannevar Bush's Memex (1945) — a personal, curated knowledge store with associative trails between documents. Bush's vision was closer to this than to what the web became: private, actively curated, with the connections between documents as valuable as the documents themselves. The part he couldn't solve was who does the maintenance. The LLM handles that.


## Note

This document is intentionally abstract. It describes the idea, not a specific implementation. The exact directory structure, the schema conventions, the page formats, the tooling — all of that will depend on your domain, your preferences, and your LLM of choice. Everything mentioned above is optional and modular — pick what's useful, ignore what isn't. For example: your sources might be text-only, so you don't need image handling at all. Your wiki might be small enough that the index file is all you need, no search engine required. You might not care about slide decks and just want markdown pages. You might want a completely different set of output formats. The right way to use this is to share it with your LLM agent and work together to instantiate a version that fits your needs. The document's only job is to communicate the pattern. Your LLM can figure out the rest.

Pour chatGPT, afin de donner du contexte à une question, on upload un fichier pdf par exemple, et on demande à chatGPT une question ce dernier saura regarder le pdf pour augmenter son texte, on appelle cela un RAG.

On va procéder différemment ici, car l’approche de Karpathy est de fabriquer un wiki qui s’augmente et se modifie, ce n’est pas seulement une accumulation de fichier, si un fichier n’a qu’une petite part d’information qui peut compléter le wiki (quelque chose de nouveau), seul le texte nouveau sera injecté dans le wiki, il sera analysé, pour voir en quoi il apporte de la valeur (complément, contradiction etc)

Coller le texte de Karpathy et ajouter à côté ce prompt :

You are a LLM Wiki agent. Implement this exact idea file as my complete second brain. create the CLAUDE.md schema file with full rules, set up index.md and log.md, define folder conventions, and show me the first ingest example.

Installer l’extension Obsidian Web Clipper pour convertir une page web en markdown

Imaginez que vous tombiez sur une page web, qui rentre dans le cadre de votre veille IA, comment ajouter le contenu de cette page à votre wiki? le meilleur format pour travailler en IA générative, c’est

Pour convertir en markdown une page, cliquez sur l’icône de l’extension, vous pouvez renommer le fichier à la volée tout en haut de la popup qui apparait, et tout en bas vous désignez le répertoire où va être enregistré le fichier markdown.

Les IA aiment travailler avec le markdown, qui est une alternative au markup (HTML), beaucoup plus dépouillé, mais porteur de valeur sémantique.

Vous allez importer dans le répertoire raw, qui est l’antichambre de vos entités sémantiques du wiki.

Une fois en possession de fichier dans raw, il est temps d’aller dans un terminal ouvert à l’emplacement de votre wiki et d’invoquer Claude Code.

Ajout de commande Claude

Créez un répertoire invisible .claude, puis un sous répertoire commands, et dedans créez 4 fichiers markdown : ingest, query,save,lint.

Mettez dans chaque commande le markdown correspondant.

query

---
description: Ask a question answered from the wiki
argument-hint: <question>
---

Run the QUERY workflow from CLAUDE.md for: $ARGUMENTS

Steps:
1. Read `index.md` to find relevant pages.
2. Read those pages and follow `[[wikilinks]]` as needed.
3. Synthesize an answer with `[[page]]` citations.
4. If the answer is substantive, offer to file it as `wiki/syntheses/<slug>.md`.
5. Append an entry to `log.md`.

save

---
description: File the last response as a synthesis page
argument-hint: [optional-slug]
---

File the previous assistant response into `wiki/syntheses/<slug>.md`.

Slug: $ARGUMENTS (if empty, derive a concise kebab-case slug from the content).

Steps:
1. Write the synthesis page with proper frontmatter (`type: synthesis`, `created`, `updated`, `tags`, `sources`).
2. Preserve `[[wikilinks]]` and add a `## References` section.
3. Update `index.md` to list the new synthesis.
4. Append an entry to `log.md`.

ingest

---
description: Ingest a source from raw/ into the wiki
argument-hint: <path-to-source-in-raw>
---

Run the INGEST workflow from CLAUDE.md on: $ARGUMENTS

Steps:
1. Read the source at $ARGUMENTS (fetch if URL).
2. Discuss 2-5 key takeaways with the user.
3. Create `wiki/sources/YYYY-MM-DD-slug.md` with summary, key claims, entities, concepts, quotes.
4. Create/update entity and concept pages for each mentioned; flag contradictions with `> [!warning]`.
5. Update `index.md`.
6. Append an entry to `log.md`.
7. Report created/updated pages, contradictions, and open questions.

lint

---
description: Lint the wiki for contradictions, orphans, and gaps
argument-hint:
---

Run the LINT workflow from CLAUDE.md.

Report on:
- Contradictions across pages
- Stale claims
- Orphan pages (no inbound links)
- Concepts mentioned without their own page
- Missing cross-references
- Data gaps worth researching

Suggest next sources to ingest.

$ARGUMENTS

C’est ingest que nous allons utiliser en premier. Dans Claude Code tapez /ingest, et il va aller regarder dans le répertoire raw digérer le fichier markdown et les répartir dans les différents répertoire du wiki. Quand c’est fait vous pouvez invoquer la vue graphique en noeud et relations dans Obsidian.

Une fois que c’est fait, vous pouvez requêter le wiki en tapant /query, et posez votre question.

Pourquoi ça marche?

Les IA sont entrainées sur des larges banques de données, mais leurs connaissance se limitent à ces données. Comme c’est une machine statistique, si vous posez une question sur un sujet dont ils n’on t pas eu connaissance, ils vont halluciner, c’est à dire inventer des choses.

Afin d’éviter cela, on leur demande de puiser des données dans des jeux de données complémentaires qui n’ont pas servi à leur entrainement, c’est le RAG (Retrieval Augmented Generation). En gros on va faire une première requête dans la source de connaissance supplémentaire (votre wiki) et envoyer le résultat de cette requête au LLM avec votre question et c’est le LLM qui va finaliser la réponse. Ceci permet de diminuer les hallucinations.

Particularité de la mise en place d’Obsidian avec la méthode de Andrej Karpathy

Ce que nous venons de faire c’est simplement constituer une base de connaissance sur un thème particulier, pas forcément pour du RAG, mais de procurer une mémoire pour vous ! imaginez que vous empiliez des livres de connaissances, mais que vous aimeriez avoir un assistant qui vous livre l’information à votre question, c’est exactement ce que va faire le LLM Claude Code. Avec ce système, chaque fois que vous découvrez une page d’informations nouvelles, vous le donnez à digérer à Claude qui va dispatcher l’information dans le wiki. Avec comme bonus qu’il n’y aura pas de répétition de cette information, et qu’il y a une vérification de si cette nouvelle information risque de contredire l’ancienne. Votre wiki est maintenu par l’IA. Vous n’avez qu’à alimenter en markdown le wiki, très facilement avec l’extension Obsidian Web Clipper.

Avoir un wiki évolutif, sur lequel on peut requêter pour avoir l’information très rapidement, une information curatée, c’est précisément pour cette raison qu’on appelle ce système un second cerveau.

Installer Claude Code votre agent codeur d’Anthropic

Claude Code : Guide d’installation et prise en main rapide

L’assistant IA qui travaille directement dans votre terminal, au cœur de votre code.


Qu’est-ce que Claude Code ?

Claude Code est l’outil en ligne de commande d’Anthropic qui transforme votre terminal en assistant de développement intelligent. Contrairement à un simple chatbot, Claude Code lit votre codebase, comprend le contexte de votre projet, écrit du code, exécute des commandes, modifie des fichiers et itère — tout cela sous votre contrôle. Que vous soyez développeur expérimenté ou que vous débutiez, il s’intègre à votre workflow sans friction.


Prérequis

Avant d’installer Claude Code, vérifiez deux points :

  • Un compte Claude.ai avec un abonnement Pro ou Max — Claude Code n’est pas disponible sur le plan gratuit.
  • macOS 13 ou supérieur — pour les utilisateurs Mac. Linux est également supporté.

C’est tout. L’installeur natif se charge du reste.


Installation sur Mac

Méthode 1 — Installeur natif (recommandée)

Ouvrez votre Terminal (Cmd + Espace, tapez Terminal, appuyez sur Entrée) et collez cette commande :

curl -fsSL https://claude.ai/install.sh | bash

L’installeur télécharge et configure automatiquement Claude Code. Quand il affiche « Claude Code successfully installed! », c’est bon.

Ensuite, mettez à jour votre PATH pour que la commande claude soit reconnue par votre terminal :

echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.zshrc && source ~/.zshrc

Vérifiez l’installation :

claude --version

Méthode 2 — Via Homebrew

Si vous utilisez Homebrew, une seule commande suffit :

brew install --cask claude-code

Méthode 3 — Via npm

Si Node.js (version 18 ou supérieure) est déjà installé sur votre machine :

npm install -g @anthropic-ai/claude-code

La méthode npm est la méthode historique, mais maintenant il y a un installateur binaire (voir ci-dessus)


Première connexion

Au premier lancement, Claude Code demande le thème graphique que vous voulez, deamnde votre méthode de login, si vous avez un compte PRO et c’est le plus souvent, c’est la première méthode, sinon vous avez d’autre méthode qui consomment l’API, (mais cette dernière va vous revenir plus cher, car le coût est calculé au nombre de token), et Claude ouvre automatiquement votre navigateur pour vous authentifier :

claude

Connectez-vous à votre compte Claude.ai et cliquez sur Authenticate. La session est ensuite sauvegardée localement — vous n’aurez plus à vous reconnecter à chaque fois.

Pour que Claude code fonctionne sur votre dossier projet, allez sur votre répertoire de projet et tapez Claude, il vous demandera systématiquement de valider que vous faites confiance à ce projet.

Prise en main : les fonctionnalités essentielles

1. Travailler dans un projet

Claude Code est conçu pour fonctionner au sein de votre projet. Naviguez dans votre dossier de travail avant de le lancer :

cd mon-projet

claude

Dès lors, Claude voit tous vos fichiers et comprend le contexte de votre codebase. Vous pouvez lui demander d’expliquer la structure du projet, de décrire une fonction, ou de repérer des incohérences.


2. Demander des modifications de code

Décrivez ce que vous voulez en langage naturel. Claude génère les changements et les présente sous forme de diff avant de les appliquer :

> Ajoute une fonction de validation d’email dans utils.py

> Refactorise cette classe pour utiliser des dataclasses Python

> Corrige le bug dans la fonction parse_date — elle ne gère pas les années bissextiles

Claude attend votre approbation avant chaque modification. Vous restez maître des changements. Vous allez être bluffé par sa capacité à écrire du code qui fonctionne, et en 20 minutes vous pouvez abattre l’équivalent d’une semaine de travail voire plus, cet effet multiplicateur est d’autant plus grand que vous vous attaquez à des technologies dont vous n’êtes pas familier ou jamais vu. Plus de crainte de rester bloqué, et plus de syndrome de l’imposteur !


3. Exécuter des commandes et des tests

Claude Code peut lancer des commandes shell directement :

> Lance les tests unitaires et explique les erreurs

> Installe les dépendances manquantes du projet

> Génère le build de production

Il interprète les résultats, identifie les erreurs et propose des corrections en boucle.


4. Le mode Plan (Shift + Tab)

Avant de se lancer dans une tâche complexe, Claude peut vous présenter un plan d’action détaillé. Appuyez sur Shift + Tab pour activer ce mode. Vous visualisez chaque étape prévue et pouvez affiner les instructions avant exécution — idéal pour les refactorisations importantes ou l’ajout de nouvelles fonctionnalités.


5. Reprendre une session précédente

Chaque conversation avec Claude Code est sauvegardée. Pour reprendre là où vous en étiez :

claude –continue   # reprend la dernière session

claude –resume     # choisit une session parmi l’historique


6. Commandes utiles à connaître

Une fois dans Claude Code, quelques raccourcis à garder en tête :

CommandeAction
/helpAffiche la liste des commandes disponibles
/modelChange le modèle Claude utilisé
/renameRenomme la session en cours
/exitQuitte Claude Code
ÉchapInterrompt Claude si une action est en cours

Extension VS Code

Si vous travaillez principalement dans VS Code, une extension Claude Code est disponible directement dans le marketplace. Elle affiche les suggestions et diffs dans un panneau latéral, avec un accès rapide depuis l’éditeur sans quitter votre environnement habituel. Mais personnellement l’outil CLI rest mon favori à 99%

Bonnes pratiques pour démarrer

Initialisez Git dans vos projets. Claude Code fonctionne bien mieux avec un historique de versions — vous pouvez rollback immédiatement si un changement ne convient pas.

Commencez par des tâches simples. Demandez-lui d’expliquer un fichier, de générer des tests unitaires, ou d’ajouter de la documentation. Cela permet de comprendre comment il interprète votre codebase avant de lui confier des modifications importantes.

Lisez les diffs avant d’approuver. Claude est efficace, mais c’est vous qui validez. Prenez l’habitude de relire chaque changement proposé.


Conclusion

Claude Code change la manière dont on interagit avec son code. Ce n’est pas un autocomplete amélioré — c’est un agent qui lit, comprend, modifie et teste votre projet de façon autonome, tout en restant sous votre supervision. L’installation prend moins de deux minutes. La prise en main, quelques heures. Et rapidement, il devient difficile de s’en passer.


Pour aller plus loin : docs officielles Claude Code

CrewAI un orchestrateur d’Agents IA en python

Dans ce tutoriel je vais vous montrer comment faire vos premiers pas avec les agents IA

Savez vous ce qu’est un agent IA?

Tout le monde parle d’agent IA mais je pense que beaucoup ne savent pas ce qu’est vraiment un agent IA.

Un agent IA est un programme propulsé par un LLM (Claude, chatGPT etc) et qui a reçu un prompt bien spécifique pour exécuter une tâche précise. Il est capable d’agir sur des informations, chercher des information via Google, manipuler des fichiers, à la différence de l’IA que vous connaissez qui ne fait que répondre à votre question.

Un agent IA est capable de communiquer avec d’autres agents IA au sein d’une équipe, il est hautement spécialisé, il peut tourner en mode séquentiel ou parallèle, et à la fin livrer un travail d’équipe dirigé par un manager.

Qu’est ce que le framework CrewAI ?

C’est une librairie Python, qui va s’occuper d’orchestrer les agents IA, les faire communiquer entre eux. La version actuelle au moment où j’écris cet article est la version 1.14 (méfiez vous des tuto périmés que vous donne les LLM et mêm le cours officiel de CrewAI !). Le site officiel de CrewAI est ici.

Pourquoi utiliser des agent IA?

L’utilisation d’agent IA spécialisé va rendre un meilleur travail qu’un LMM tout seul.

Exemple basique avec l’analyse

Pour utiliser CrewAI, il vous faut 3 chose : les agents, les tâches (Task) et le Crew. On va aussi affecter un LLM à chaque agent, et on peut affecter un LLM différent au manager des agents.

Mise en place de l’environnement virtuel et installation des paquets

Pour chaque projet il est important de mettre en place un environnement virtuel pour isoler les librairies de l’installation globale de python. Ainsi allez dans un endroit qui vous plait pour votre projet.

# dans un répertoire dédié à votre projet faites la création de l'environnement virtuel
#creation de l'environnement virtuel
python -m venv venv

#Puis dans votre environnement virtuel
python -m pip install crewai crewai-tools python-dotenv

un fichier .env.example

Usage du script

pour faire simple une action est passée par défaut
python run.py

Mais vous pouvez passez en argument une autre action
le script prend jusqu'à 4 arguments.
python run.py --stock TSLA --risk High --strategy "Swing Trading"

Description de ce qui se passe quand vous lancez le script

1. Le Manager LLM lit les tâches et décide qui fait quoi et dans quel ordre.

2. Les agents s’exécutent en séquence, chacun produisant un « thought process » visible :

  • Thought: → l’agent réfléchit à ce qu’il doit faire
  • Action: → il décide d’utiliser un outil (scraping, recherche…)
  • Action Input: → les paramètres qu’il passe à l’outil
  • Observation: → le résultat retourné par l’outil
  • Final Answer: → sa conclusion pour cette tâche

3. Le Manager valide chaque résultat avant de passer à la tâche suivante.

4. Les 4 agents travaillent dans l’ordre :

  • Data Analyst → analyse le marché AAPL
  • Trading Strategy Developer → propose des stratégies
  • Trade Advisor → planifie l’exécution
  • Risk Advisor → évalue les risques et produit le rapport final

Tout cet output verbose c’est le « raisonnement » des agents rendu visible — c’est ce qui rend crewAI intéressant à observer. Tu peux mettre verbose=False sur les agents et le crew pour n’avoir que le résultat final.

Comment crewAI scripte un agent

data_analyst_agent = Agent(
    role="Data Analyst",
    goal=(
        "Monitor and analyze market data in real-time "
        "to identify trends and predict market movements."
    ),
    backstory=(
        "Specializing in financial markets, this agent "
        "uses statistical modeling and machine learning "
        "to provide crucial insights. With a knack for data, "
        "the Data Analyst Agent is the cornerstone for "
        "informing trading decisions."
    ),
    verbose=True,
    allow_delegation=True,
    tools=tools,
    llm=llm,
)

Le backstory est le texte qui décrite (prompte) l’agent. Le paramètre llm indique le LLM à utiliser. allow_delegation permet à un agent de confier sa mission à un autre agent dès lors qu’il pense qu’il n’est pas le mieux dans une tâche. Si vous débutez mettez à False. tools quant à lui est une liste d’outils (qu’il faut déclarer) pour que l’agent puisse le solliciter pour faire autre chose que de répondre comme un LMM basiquement. Dans la section 5 on a tools = [scrape_tool, search_tool]. Pour Serper il vous faudra aller sur leur site créer un compte et obtenir une clé API. Il vous faut aussi une clé API openAI.

Voir la liste des outils potentiels

python -c "import crewai_tools; print(dir(crewai_tools))"

# va vous donner une grande liste d'outils
['AIMindTool', 'ApifyActorsTool', 'ArxivPaperTool', 'BedrockInvokeAgentTool', 'BedrockKBRetrieverTool', 'BraveImageSearchTool', 'BraveLLMContextTool', 'BraveLocalPOIsDescriptionTool', 'BraveLocalPOIsTool', 'BraveNewsSearchTool', 'BraveSearchTool', 'BraveVideoSearchTool', 'BraveWebSearchTool', 'BrightDataDatasetTool', 'BrightDataSearchTool', 'BrightDataWebUnlockerTool', 'BrowserbaseLoadTool', 'CSVSearchTool', 'CodeDocsSearchTool', 'ComposioTool', 'ContextualAICreateAgentTool', 'ContextualAIParseTool', 'ContextualAIQueryTool', 'ContextualAIRerankTool', 'CouchbaseFTSVectorSearchTool', 'CrewaiPlatformTools', 'DOCXSearchTool', 'DallETool', 'DatabricksQueryTool', 'DaytonaExecTool', 'DaytonaFileTool', 'DaytonaPythonTool', 'DirectoryReadTool', 'DirectorySearchTool', 'E2BExecTool', 'E2BFileTool', 'E2BPythonTool', 'EXASearchTool', 'EnterpriseActionTool', 'FileCompressorTool', 'FileReadTool', 'FileWriterTool', 'FirecrawlCrawlWebsiteTool', 'FirecrawlScrapeWebsiteTool', 'FirecrawlSearchTool', 'GenerateCrewaiAutomationTool', 'GithubSearchTool', 'HyperbrowserLoadTool', 'InvokeCrewAIAutomationTool', 'JSONSearchTool', 'JinaScrapeWebsiteTool', 'LinkupSearchTool', 'LlamaIndexTool', 'MCPServerAdapter', 'MDXSearchTool', 'MergeAgentHandlerTool', 'MongoDBVectorSearchConfig', 'MongoDBVectorSearchTool', 'MultiOnTool', 'MySQLSearchTool', 'NL2SQLTool', 'OCRTool', 'OxylabsAmazonProductScraperTool', 'OxylabsAmazonSearchScraperTool', 'OxylabsGoogleSearchScraperTool', 'OxylabsUniversalScraperTool', 'PDFSearchTool', 'ParallelSearchTool', 'PatronusEvalTool', 'PatronusLocalEvaluatorTool', 'PatronusPredefinedCriteriaEvalTool', 'QdrantVectorSearchTool', 'RagTool', 'S3ReaderTool', 'S3WriterTool', 'ScrapeElementFromWebsiteTool', 'ScrapeWebsiteTool', 'ScrapegraphScrapeTool', 'ScrapegraphScrapeToolSchema', 'ScrapflyScrapeWebsiteTool', 'SeleniumScrapingTool', 'SerpApiGoogleSearchTool', 'SerpApiGoogleShoppingTool', 'SerperDevTool', 'SerperScrapeWebsiteTool', 'SerplyJobSearchTool', 'SerplyNewsSearchTool', 'SerplyScholarSearchTool', 'SerplyWebSearchTool', 'SerplyWebpageToMarkdownTool', 'SingleStoreSearchTool', 'SnowflakeConfig', 'SnowflakeSearchTool', 'SpiderTool', 'StagehandTool', 'TXTSearchTool', 'TavilyExtractorTool', 'TavilySearchTool', 'VisionTool', 'WeaviateVectorSearchTool', 'WebsiteSearchTool', 'XMLSearchTool', 'YoutubeChannelSearchTool', 'YoutubeVideoSearchTool', 'ZapierActionTool', 'ZapierActionTools', '__all__', '__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__path__', '__spec__', '__version__', 'adapters', 'aws', 'rag', 'security', 'tools']

verbose permet d’afficher dans le terminal ce qui se passe. le goal répond à « pourquoi tu existes dans cette équipe », la tâche répond à « qu’est-ce que tu fais maintenant », alors que le backstory décrit l’agent.

Les Task

data_analysis_task = Task(
    description=(
        "Continuously monitor and analyze market data for "
        "the selected stock ({stock_selection}). "
        "Use statistical modeling and machine learning to "
        "identify trends and predict market movements."
    ),
    expected_output=(
        "Insights and alerts about significant market "
        "opportunities or threats for {stock_selection}."
    ),
    agent=data_analyst_agent,
)

expected_out est une instruction envoyée au LLM. Il y a différents niveau de contrainte, détaillées ci-dessous :

Niveau 1 : il faut être très précis

#  vague
expected_output="Un rapport d'analyse."

#  précis
expected_output=(
    "Un rapport structuré avec exactement ces sections : "
    "1) Tendances actuelles, 2) Opportunités, 3) Risques, "
    "4) Recommandation finale en une phrase. "
    "Format markdown, maximum 500 mots."
)

Niveau 2 : ajouter un guardrail (validation automatique)

task = Task(
    description="Analyse le stock {stock_selection}.",
    expected_output="Un rapport avec tendances, opportunités et risques.",
    agent=analyst,
    guardrail=(
        "Le rapport doit contenir les mots 'tendances', 'opportunités' "
        "et 'risques'. Il doit faire au moins 200 mots."
    )
)

Niveau 3 : forcer un formation JSON avec Pydantic (le plus strict)

from pydantic import BaseModel
from typing import List

class AnalysisReport(BaseModel):
    tendances: List[str]
    opportunites: List[str]
    risques: List[str]
    recommandation: str

task = Task(
    description="Analyse le stock {stock_selection}.",
    expected_output="Un rapport d'analyse structuré.",
    agent=analyst,
    output_pydantic=AnalysisReport,  # force le format
)

# Accès au résultat structuré après kickoff :
result = crew.kickoff(inputs={"stock_selection": "AAPL"})
print(result.pydantic.recommandation)
print(result.pydantic.risques)

Voici le code source intégral

"""
run.py — Analyse financière multi-agents avec crewAI v1.x
----------------------------------------------------------
Compatible : crewai >= 1.0 (testé sur 1.14)

Installation :
    pip install crewai crewai-tools python-dotenv

Fichier .env requis :
    OPENAI_API_KEY=sk-...
    SERPER_API_KEY=...     (optionnel, pour la recherche web)

Usage :
    python run.py
    python run.py --stock TSLA --risk High --strategy "Swing Trading"
"""

import os
import argparse
from dotenv import load_dotenv

# ── 1. Variables d'environnement ─────────────────────────────────────────────
load_dotenv()

if not os.getenv("OPENAI_API_KEY"):
    raise EnvironmentError(
        "OPENAI_API_KEY manquant !\n"
        "Crée un fichier .env avec : OPENAI_API_KEY=sk-..."
    )

# ── 2. Arguments CLI ──────────────────────────────────────────────────────────
parser = argparse.ArgumentParser(description="Analyse financière multi-agents crewAI v1.x")
parser.add_argument("--stock",    default="AAPL",        help="Ticker boursier (défaut: AAPL)")
parser.add_argument("--capital",  default="100000",      help="Capital initial (défaut: 100000)")
parser.add_argument("--risk",     default="Medium",      choices=["Low", "Medium", "High"])
parser.add_argument("--strategy", default="Day Trading", help="Stratégie de trading")
args = parser.parse_args()

# ── 3. Imports crewAI v1.x ───────────────────────────────────────────────────
# CHANGEMENT v1.x : on n'importe plus depuis langchain_openai
# crewAI gère le LLM en interne via LiteLLM
from crewai import Agent, Task, Crew, Process, LLM
from crewai_tools import ScrapeWebsiteTool, SerperDevTool


# ── 4. LLM ───────────────────────────────────────────────────────────────────
# CHANGEMENT v1.x : on utilise crewai.LLM au lieu de langchain_openai.ChatOpenAI
# Le préfixe "openai/" est la convention LiteLLM
llm = LLM(
    model="openai/gpt-4o-mini",   # ou "openai/gpt-4o", "openai/gpt-3.5-turbo"
    temperature=0.7,
    api_key=os.getenv("OPENAI_API_KEY"),
)

# LLM dédié au manager (peut être le même ou un modèle plus puissant)
manager_llm = LLM(
    model="openai/gpt-4o-mini",
    temperature=0.7,
    api_key=os.getenv("OPENAI_API_KEY"),
)

# ── 5. Outils ────────────────────────────────────────────────────────────────
# SerperDevTool nécessite SERPER_API_KEY dans .env
# Sans clé, les agents raisonnent sur leurs connaissances sans chercher sur le web
search_tool = SerperDevTool()
scrape_tool = ScrapeWebsiteTool()
tools = [scrape_tool, search_tool]


# ── 6. Agents ────────────────────────────────────────────────────────────────
# CHANGEMENT v1.x : on passe `llm=` explicitement à chaque agent

data_analyst_agent = Agent(
    role="Data Analyst",
    goal=(
        "Monitor and analyze market data in real-time "
        "to identify trends and predict market movements."
    ),
    backstory=(
        "Specializing in financial markets, this agent "
        "uses statistical modeling and machine learning "
        "to provide crucial insights. With a knack for data, "
        "the Data Analyst Agent is the cornerstone for "
        "informing trading decisions."
    ),
    verbose=True,
    allow_delegation=True,
    tools=tools,
    llm=llm,
)

trading_strategy_agent = Agent(
    role="Trading Strategy Developer",
    goal=(
        "Develop and test various trading strategies based "
        "on insights from the Data Analyst Agent."
    ),
    backstory=(
        "Equipped with a deep understanding of financial "
        "markets and quantitative analysis, this agent "
        "devises and refines trading strategies. It evaluates "
        "the performance of different approaches to determine "
        "the most profitable and risk-averse options."
    ),
    verbose=True,
    allow_delegation=True,
    tools=tools,
    llm=llm,
)

execution_agent = Agent(
    role="Trade Advisor",
    goal=(
        "Suggest optimal trade execution strategies "
        "based on approved trading strategies."
    ),
    backstory=(
        "This agent specializes in analyzing the timing, price, "
        "and logistical details of potential trades. By evaluating "
        "these factors, it provides well-founded suggestions for "
        "when and how trades should be executed to maximize "
        "efficiency and adherence to strategy."
    ),
    verbose=True,
    allow_delegation=True,
    tools=tools,
    llm=llm,
)

risk_management_agent = Agent(
    role="Risk Advisor",
    goal=(
        "Evaluate and provide insights on the risks "
        "associated with potential trading activities."
    ),
    backstory=(
        "Armed with a deep understanding of risk assessment models "
        "and market dynamics, this agent scrutinizes the potential "
        "risks of proposed trades. It offers a detailed analysis of "
        "risk exposure and suggests safeguards to ensure that "
        "trading activities align with the firm's risk tolerance."
    ),
    verbose=True,
    allow_delegation=True,
    tools=tools,
    llm=llm,
)

# ── 7. Tâches ────────────────────────────────────────────────────────────────
# Les {accolades} sont remplacées par les valeurs de `inputs` au kickoff

data_analysis_task = Task(
    description=(
        "Continuously monitor and analyze market data for "
        "the selected stock ({stock_selection}). "
        "Use statistical modeling and machine learning to "
        "identify trends and predict market movements."
    ),
    expected_output=(
        "Insights and alerts about significant market "
        "opportunities or threats for {stock_selection}."
    ),
    agent=data_analyst_agent,
)

strategy_development_task = Task(
    description=(
        "Develop and refine trading strategies based on "
        "the insights from the Data Analyst and "
        "user-defined risk tolerance ({risk_tolerance}). "
        "Consider trading preferences ({trading_strategy_preference})."
    ),
    expected_output=(
        "A set of potential trading strategies for {stock_selection} "
        "that align with the user's risk tolerance."
    ),
    agent=trading_strategy_agent,
    context=[data_analysis_task],   # reçoit le résultat de la tâche précédente
)

execution_planning_task = Task(
    description=(
        "Analyze approved trading strategies to determine the "
        "best execution methods for {stock_selection}, "
        "considering current market conditions and optimal pricing."
    ),
    expected_output=(
        "Detailed execution plans suggesting how and when to "
        "execute trades for {stock_selection}."
    ),
    agent=execution_agent,
    context=[strategy_development_task],
)

risk_assessment_task = Task(
    description=(
        "Evaluate the risks associated with the proposed trading "
        "strategies and execution plans for {stock_selection}. "
        "Provide a detailed analysis of potential risks "
        "and suggest mitigation strategies."
    ),
    expected_output=(
        "A comprehensive risk analysis report detailing potential "
        "risks and mitigation recommendations for {stock_selection}."
    ),
    agent=risk_management_agent,
    context=[strategy_development_task, execution_planning_task],
    output_file="result_{stock_selection}.md",  # sauvegarde automatique
    markdown=True,
)

# ── 8. Crew ───────────────────────────────────────────────────────────────────
# CHANGEMENT v1.x :
#   - manager_llm prend un objet crewai.LLM (plus de ChatOpenAI)
#   - Process.hierarchical toujours supporté
financial_trading_crew = Crew(
    agents=[
        data_analyst_agent,
        trading_strategy_agent,
        execution_agent,
        risk_management_agent,
    ],
    tasks=[
        data_analysis_task,
        strategy_development_task,
        execution_planning_task,
        risk_assessment_task,
    ],
    manager_llm=manager_llm,
    process=Process.hierarchical,
    verbose=True,
)

# ── 9. Inputs et lancement ────────────────────────────────────────────────────
financial_trading_inputs = {
    "stock_selection":             args.stock,
    "initial_capital":             args.capital,
    "risk_tolerance":              args.risk,
    "trading_strategy_preference": args.strategy,
    "news_impact_consideration":   True,
}

print("\n" + "=" * 60)
print("  ANALYSE FINANCIÈRE MULTI-AGENTS — crewAI v1.x")
print("=" * 60)
print(f"  Ticker    : {financial_trading_inputs['stock_selection']}")
print(f"  Capital   : ${financial_trading_inputs['initial_capital']}")
print(f"  Risque    : {financial_trading_inputs['risk_tolerance']}")
print(f"  Stratégie : {financial_trading_inputs['trading_strategy_preference']}")
print("=" * 60)
print("\n⚡ Démarrage... (peut prendre 2–5 minutes)\n")

result = financial_trading_crew.kickoff(inputs=financial_trading_inputs)

print("\n" + "=" * 60)
print("  RÉSULTAT FINAL")
print("=" * 60 + "\n")
print(result)
print(f"\n✅ Rapport sauvegardé dans : result_{args.stock.lower()}.md")

QMD un moteur de recherche de documents markdown

Pour installer ce logiciel, il vaut mieux être sous Linux, aussi si vous êtes sous Windows, soit vous allez dans WSL soit vous utilisez Gitbash pour l’installer, sinon Windows ne trouvera pas le programme.

Le fonctionnement est repris du site officiel :

Voici le repository : https://github.com/tobi/qmd

Installation de QMD

npm install -g @tobilu/qmd

// pour ajouter un répertoire à indexer
qmd collection add ~/notes --name notes

ci dessus c'est un chemin Linux, par exemple si vous êtes dans Document et que vous êtes l'utilisateur John, le chemin devient : /mnt/c/Users/John/Documents

qmd collection add /mnt/c/Users/John/Documents --name mesdocuments

L’intérêt de QMD est que nous vivons à l’âge de l’intelligence artificielle, et l’outil s’intègre très bien dans des workflow agentiques.

Récemment Andrej Karpathy a publié une solution à base d’Obsidian https://x.com/karpathy/status/2039805659525644595?s=46 pour construire un wiki à base de fichier md, capable de s’enrichir de façon incrémental, offrant une solution alternative au RAG.

QMD peut donc s’utiliser en IA agentique. Car tout ce qui est à base de markdown est utilisé comme support d’information pour les LLM, car c’est un formation structuré et vecteur d’information qui minimise l’utilisation de token.

Les RAG comme les MCP sont des solutions pour doter les LLM d’un contexte sur lequel ils n’ont pas été entrainés, évitant ainsi des hallucinations.

Par extension, aujourd’hui des gens s’intéresse à ce qu’on appelle un second cerveau (après le nôtre), l’idée est de combler ce qui manque au LLM : une mémoire persistante, qui le rendrait vraiment très efficace (pensez à Jarvis de Iron Man)

Maitriser ce skills vous permettre de concevoir un assistant vraiment efficace et opérationnel.

Les Skills Claude : le guide complet pour étendre les capacités de votre IA

Si vous utilisez Claude régulièrement, vous avez peut-être remarqué qu’il adapte son comportement selon les contextes — il sait créer des documents Word propres, lire des PDFs complexes, ou générer des présentations PowerPoint clé en main. Derrière cette magie, il y a souvent un skill. Ce tutoriel vous explique tout : ce que c’est, comment en créer un, comment le rendre vraiment efficace, et comment Claude décide de l’utiliser.

Qu’est-ce qu’un skill ?

Un skill est un fichier d’instructions que vous donnez à Claude pour lui apprendre à accomplir une tâche spécifique de façon reproductible et de qualité professionnelle.
Imaginez que vous êtes chef cuisinier et que vous recrutez un assistant. Plutôt que de lui expliquer chaque soir comment préparer votre sauce signature, vous lui remettez une fiche recette détaillée : les ingrédients, les étapes dans l’ordre, les erreurs à éviter, les variantes possibles. C’est exactement ça, un skill. Avant je faisais toujours un long prompt avec des différence entre chaque fois, donc avec un skill c’est beaucouyp plus carré et je suis sûr de ne rien oublier, et je peux même améliorer mon skill puisque vous pouvez versionner le skill sur Github.

Concrètement, un skill c’est :

  • Un dossier portant le nom du skill (ex : docx/, pdf/, pptx/)
  • Un fichier principal appelé SKILL.md — le cœur du skill
  • Optionnellement : des scripts, des fichiers de référence, des assets (modèles, polices, icônes…)
mon-skill/

├── SKILL.md              ← obligatoire
├── scripts/              ← scripts réutilisables
├── references/           ← documentation technique
└── assets/               ← templates, polices, image

À quoi ça sert concrètement un skill ?

Sans skill, si vous demandez à Claude « crée-moi un document Word professionnel », il va faire de son mieux — mais il risque d’oublier de gérer les styles, la table des matières, les en-têtes, les numéros de page. Avec un skill docx, Claude suit une méthode éprouvée : il installe les bonnes librairies Python, utilise python-docx de la bonne façon, applique une mise en page cohérente. Le résultat est radicalement différent.

Les skills servent à :

  • Capitaliser sur une méthode qui fonctionne bien
  • Standardiser les sorties pour qu’elles soient toujours de qualité
  • Éviter de réexpliquer la même chose à chaque conversation

Gérer des cas complexes avec des scripts et des ressources bundlées

Comment est structuré un SKILL.md ?

Le fichier SKILL.md a deux parties : un en-tête YAML (appelé frontmatter) et un corps en Markdown.

---

name: mon-skill

description: Ce que fait ce skill et quand l'utiliser. Inclure les déclencheurs spécifiques.

---

# Corps du skill

## Ce que Claude doit faire

Le frontmatter : la clé du déclenchement

Le frontmatter contient deux champs essentiels :

name — l’identifiant du skill. Simple, en minuscules, avec des tirets.

description — c’est le champ le plus important de tout le skill. C’est grâce à lui que Claude décide d’utiliser (ou non) le skill. Claude ne lit pas l’intégralité du skill à chaque requête — il scanne les descriptions de tous les skills disponibles et choisit lesquels consulter.

Pour une bonne description répondez à ces trois questions :

  1. Qu’est-ce que ce skill fait ?
  2. Dans quelles contextes l’utiliser ?
  3. Quels mots-clés ou situations doivent le déclencher ?
description: >
  Crée des documents Word (.docx) professionnels avec mise en page avancée.
  Utiliser dès que l'utilisateur mentionne "Word", "docx", ".docx", ou demande
  un rapport, mémo, lettre, ou tout document téléchargeable. Également utile
  pour extraire du contenu depuis un .docx existant ou pour insérer des images
  dans un document Word.

Le corps : les instructions pour Claude

Le corps du SKILL.md contient tout ce dont Claude a besoin pour accomplir la tâche : étapes à suivre, formats de sortie attendus, exemples, cas limites à gérer, erreurs courantes à éviter.

Il n’y a pas de format imposé — c’est du Markdown libre. :

## Workflow

1. Installer les dépendances : `pip install python-docx --break-system-packages`
2. Créer le document avec les styles appropriés
3. Sauvegarder dans /mnt/user-data/outputs/

## Format de sortie

Toujours utiliser cette structure :
- En-tête avec titre et date
- Table des matières si > 3 sections
- Pied de page avec numéros de page

## Exemples

**Exemple 1 :**
Requête : "Fais-moi un rapport d'analyse"

Action : Créer un .docx avec titre, TOC, sections numérotées

## À ne pas faire
- Ne pas utiliser reportlab (pour les PDFs, pas les .docx)
- Ne pas oublier d'appeler present_files à la fin

Le système de chargement progressif

Un des concepts les plus élégants des skills est la progressive disclosure : un système à trois niveaux.

Niveau 1 : Métadonnées (toujours en contexte)

  name + description (~100 mots)

Niveau 2 : Corps du SKILL.md (chargé quand le skill est déclenché)

  Instructions complètes (<500 lignes idéalement)

Niveau 3 : Ressources bundlées (chargées à la demande)

  Scripts, références, assets (taille illimitée)

Cela signifie que Claude ne lit pas tous les skills en entier à chaque requête — ce serait beaucoup trop lourd. Il ne consulte que ce dont il a besoin, au moment où il en a besoin. A la différence des serveurs MCP qui peuvent être gourmand en tokens.
Implication pratique : gardez votre SKILL.md sous 500 lignes. Si vous avez beaucoup de documentation (par exemple, plusieurs frameworks cloud : AWS, GCP, Azure), mettez-la dans des fichiers de référence séparés et indiquez dans le SKILL.md quand les lire :

## Documentation spécifique par plateforme

Selon la plateforme demandée, lire le fichier correspondant :
- AWS → references/aws.md
- GCP → references/gcp.md  
- Azure → references/azure.md

Pensez à économiser vos tokens !

Comment créer un bon skill

Je sais qu’il existe des sites qui listent des milliers de skills, mais vous devez apprendre à les concocter vous même. Vous pouvez néanmoins vous inspirer pour faire les votre, comme ça vous comprendrez ce que vous faites.

Voici les principes qui distinguent un skill basique d’un skill vraiment efficace.

Principe 1 : la description est reine

Répétons-le car c’est crucial : la description détermine si le skill sera utilisé ou non. Une description trop vague = skill ignoré. Une description trop restrictive = skill sous-utilisé.

La description doit être légèrement « assertive » — elle doit pousser Claude à utiliser le skill dans tous les cas pertinents. Comparez :

description: Outil pour créer des dashboards. << trop vague

  Crée des dashboards interactifs pour visualiser des données internes.
  Utiliser dès que l'utilisateur mentionne des dashboards, de la visualisation
  de données, des métriques, ou veut afficher n'importe quel type de données
  d'entreprise — même sans le mot "dashboard" explicitement.
  ^ beaucoup plus précis, le contexte est plus riche, moins de devinette de la part du LLM.

Principe 2 : le principe de moindre surprise

Le comportement du skill doit correspondre exactement à ce que sa description promet. Un skill qui fait des choses inattendues crée de la confusion. Si votre description dit « crée des PDFs », le skill ne devrait pas aussi modifier des fichiers Excel sans le mentionner.

Principe 3 : préférez l’impératif dans les instructions

Les instructions doivent être claires et directes :

Il serait bien d'installer les dépendances  << trop vague, ce n'est pas un ordre...

"Installer les dépendances avec pip install python-docx --break-system-packages" << précis et impératif

Principe 4 : inclure des exemples

Les exemples sont parmi les éléments les plus puissants d’un skill. Ils ancrent les instructions dans le concret :

## Exemples de messages de commit

Input: "Ajout de l'authentification avec JWT"
Output: feat(auth): implement JWT-based authentication
Input: "Correction du bug d'affichage sur mobile"
Output: fix(ui): resolve display issue on mobile screens

Principe 5 : anticipez les cas limites

Qu’est-ce qui peut mal tourner ? Documentez-le :

## Cas limites et erreurs courantes

- Si le fichier est trop volumineux (>50MB), prévenir l'utilisateur et proposer de traiter par chunks
- Si python-docx n'est pas disponible, l'installer avec --break-system-packages
- Si l'utilisateur ne précise pas de langue, utiliser le français par défaut

Principe 6 : déléguez aux scripts pour les tâches répétitives

Pour des opérations complexes et reproductibles, créez des scripts dans scripts/. Claude peut les exécuter sans même les lire entièrement — ce qui économise du contexte et garantit la cohérence.

## Création du document

Exécuter le script de génération :
```bash
python scripts/generate_report.py --title "$TITRE" --output /mnt/user-data/outputs/
---
## 5. Comment Claude décide d'invoquer un skill
C'est la question que tout créateur de skills se pose : quand est-ce que Claude va réellement utiliser mon skill ?
### Le mécanisme de déclenchement
### Ce qui favorise le déclenchement

- **Des mots-clés dans la requête** qui correspondent à la description du skill
- **La complexité de la tâche** — les tâches multi-étapes déclenchent mieux
- **Une description assertive** qui liste explicitement les déclencheurs
- **Le format de sortie attendu** — si l'utilisateur mentionne ".docx", ".pdf", ".pptx"
### Ce qui empêche le déclenchement
- Description trop vague ou trop générique
- Tâche trop simple (Claude la gère sans aide)
- Mots-clés absents de la description
### Astuce : tester et optimiser

Pour vérifier qu’un skill se déclenche bien, essayez différentes formulations de requête et observez si Claude consulte le skill. Si des requêtes légitimes passent à travers, enrichissez la description avec ces formulations.

Il existe même des outils d’optimisation automatique (comme run_loop.py dans l’outil skill-creator) qui testent la description avec des dizaines de variantes et proposent des améliorations basées sur les résultats.

Les skills par défaut de Claude

Vous avez dû sans doute rencontré ces skills car il les affiche dans la version web : docx, pptx,pdf,xlsx, frontend-design (en tant que dév web je le vois souvent), et skill-creator (un skill puor créer des skills !)

Qu’est ce que le python launcher?

Une des difficultés que je rencontre avec Python est le global et le local, les différents version de python runtime installée, parfois les scripts nécessite une version spécifique de Python, c’est là que trouve son utilité le python launcher

# lister les version de python installée
$ py --list

Installer plusieurs versions de python

Pour installer plusieurs version de python, vous pouvez allez sur le site officiel python.org et sélectionnez les versions que vous voulez télécharger. Mais, attention, pour les anciennes version, les installeur n’existent plus, et il faut compiler à partir du code source, pas pratique.

Mais selon cette page, à partir de la version 3.16 de python, le python install manager sera discontinué.

pyenv-win

C’est l’outil en ligne pour installer plusieurs versions de python.

# pour installer sous Powershell
pip install pyenv-win --target "$HOME\.pyenv"

# il est peut être préférable d'installer via GIT
git clone https://github.com/pyenv-win/pyenv-win.git "$HOME\.pyenv"

#ajout au PATH
[System.Environment]::SetEnvironmentVariable('PYENV',"$HOME\.pyenv\pyenv-win","User")
[System.Environment]::SetEnvironmentVariable('PATH',"$HOME\.pyenv\pyenv-win\bin;$HOME\.pyenv\pyenv-win\shims;$env:PATH","User")

# exemple de commandes
pyenv install 3.10.5   # Installe Python 3.10.5
pyenv install 3.11.9    # Installe Python 3.11.9
pyenv versions          # Liste les versions installées
pyenv global 3.11.9     # Définit la version par défaut
pyenv local 3.10.11     # Définit la version pour le dossier courant

Solution plus moderne Python Install Manager

Allez sur cette page https://www.python.org/downloads/release/pymanager-261/, téléchargez le binaire et installez le. Puis pour installer une version spécifique de python :

pymanager install 3.12

Note 1:

Quand vous faites des commandes en shell sous Windows, distinguez bien Powershell, CMD, gitbash, cela peut avoir une grande incidence sur la réussite de la commande.

N’installez pas seulement la dernière version de python, en effet les librairies ne suivent pas aussi vite les version de Python, particulièrement en machine learning, je suis confronté à des erreurs car j’avais la dernière version.

Note 2:

python -m pip est toujours plus sûr car ça garantit que l’installation se fait dans le même Python que celui qui exécute ton script.

python -m pip install librosa